FAQ 汇总
格式要求:
问答类
不涉及具体方案步骤和流程性的问题可以参考如下格式。
问:(不涉及具体方案和流程性问题)
答:(判断、对错、简要知识点)
操作类
一些问题排查,涉及到问题现象、原因分析、解决方案等内容的 FAQ 可以参考如下格式。
问题现象
简单描述遇到的问题的操作、所用软件的版本、报错关键日志、错误码、抛出的异常等信息,方便参考及复现。
可能原因
描述可能导致该问题的原因。
解决方案
描述解决该问题的方法或临时规避手段。
问题之间使用 --- 进行分割。
问答
知识点
问:社区版 OceanBase 数据库支持 IPv6 网络吗?
答:当前版本暂不支持,预计 OceanBase 数据库 4.2 版本支持。
问:OceanBase 数据库 4.x 版本支持哪几种备份介质?
答:目前已支持 NFS、阿里云 OSS、腾讯云 COS。
问:OceanBase 数据库 4.0 版本触发器、存储过程、自定义函数最大支持长度是多少?
答:触发器最大支持 65536 字节,存储和自定义函数 clob 类型存储,基本可理解为无上限。
问:OceanBase 数据库的主键是否是聚簇索引?
答:是的。
问:OceanBase 数据库 4.x 版本如何进行 rs 切主?
答:可执行ALTER SYSTEM SWITCH REPLICA leader LS=1 SERVER='目标ip:rpc_port' TENANT ='sys';命令进行切主,示例如下。`ALTER SYSTEM SWITCH REPLICA leader LS=1 SERVER ='xx.xx.xx.xx:2882' TENANT ='sys';`
问:OceanBase 数据库是否能只进行数据备份,不做日志备份呢?
答:进行数据备份前提是开启日志备份,不支持只做数据备份。
问:为什么刚部署的 OceanBase 数据库,数据和日志磁盘占用 90%,或者占用很大?
答:OceanBase 数据库的数据和日志目录采用的是预占用机制,只能动态增加占用大小,暂不支持缩小。不过 OceanBase 数据库 4.1 版本支持 log_disk_size 动态扩缩。OceanBase 数据库 4.x 版本磁盘预占用相关参数为:
数据磁盘:datafile_size / datafile_disk_percentage
日志磁盘:log_disk_size / log_disk_percentage
问:下划线开头格式的参数为隐藏参数,无法通过 SHOW PARAMETERS 语句来查询?
答:可通过如下命令查看。`SELECT * FROM oceanbase.__all_virtual_sys_parameter_stat WHERE name='_ob_enable_prepared_statement';`
问:如何清理租户并释放空间?
答:先执行drop tenant xxx force;命令删除租户,再执行drop resource pool xxx;命令删除对应的资源池。
两条命令均成功执行才算释放空间。但需注意该操作会清理租户下的所有数据。
问:MySQL 迁移到 OceanBase 数据库还需要用 ShardingSphere 做分库分表吗?
答:不需要,OceanBase 数据库本身支持分区表,可以通过分区表设计业务。
问:主机资源够的情况下,多个 Server 可以部署在同一台主机吗?
答:手动部署和使用 OBD 部署均支持该场景,使用 OCP 部署不支持该场景。如果使用 OBD 工具部署需使用obd cluster deploy命令修改端口和安装目录。但生产环境不建议如此部署,单服务器单 observer 进程最佳。
问:使用 OBD 部署社区版三节点集群,必须使用 admin 用户吗?
答:非强制要求,但是建议使用 admin 用户部署,后期 OCP 接管的集群需要是使用 admin 用户部署的 OceanBase 数据库。
问:使用 OceanBase 数据库社区版 3.x 部署一个读写分离的集群时,可以部署 4 个 Zone,其中 3 个 Zone 是全能型副本,一个 Zone 是只读的副本吗?
答:建议 Zone 的数量最好是奇数,以 3 个 Zone 或 5 个 Zone 为主。
问:手动部署的 OceanBase 数据库可以用 OBD 管理吗?
答:不支持。
问:OMS 可以搭建集群吗?
答:目前社区版 OMS 3.3.1 版本支持集群化部署,低于此版本不支持。
问:社区版 MySQL 模式的 JDBC 驱动在哪下载?
答:如果使用 OceanBase 数据库的 MySQL 模式,推荐使用 MySQL JDBC 驱动 5.1.47 版本。
如果使用企业版 OceanBase 数据库的 Oracle 模式,可从 Maven 中央仓库 下载的 OceanBase 数据库的 JDBC 驱动。
问:使用 SpringBoot 连接 OceanBase 数据库的正确写法是什么?
答:可以参考 MySQL 连接方式,区别在于通过直连 OBServer 节点连接时 username 写法是用户名@租户名,通过 OBProxy 代理连接时 username 写法是用户名@租户名#集群名。
问:OBD 部署失败,怎么清理配置和目录?
答:2 种方式:
1)命令方式:`obd cluster destory 部署名称,销毁会清理相关目录。
2)后台方式:杀掉所部署组件相关进程(ps -ef|grep observer),按部署配置文件里配置路径删除安装、数据、日志目录,并检查目录所属用户权限是否正确即可重新部署。
问:OCP 的 Docker 容器是否为无状态?
答:无状态,数据保留在部署在宿主机上的 metadb(单机/集群 OceanBase 数据库)中。
问:内部表和内部虚拟表是什么?
答:内部表一般指系统表,虚拟表只是系统表中的一部分,ID 号介与 10000~20000 之间。
问:备份数据时候,需要每个 OBServer 节点都挂载 NFS 吗?
答:是的。
问:备份可以备份单个租户的么?
答:OceanBase 数据库 3.x 版本只支持集群备份,4.0 版本起支持租户级别备份,且不再支持集群级别备份。
问:副本保持同步是通过同步 clog 吗?
答:是的,以分区为单位做 clog 副本同步,只有分区的主副本才能进行更新,如果有多个分区的主副本同时在更新,仍然以分区为单位做 Paxos 同步。
问:社区版 OceanBase 数据库怎么查看哪些表是复制表?
答:3.x 版本中通过所示命令查看。`select table_name from oceanbase.__all_table_v2 where duplicate_scope=1;`
问:OceanBase 数据库 4.0 版本中,CDB 开头的视图、DBA 开头的视图、GV 开头的视图,这些是什么规则?
答:CBD 开头的是 sys 租户的视图,能看到全局的信息。DBA 开头的视图只能看到租户自己的信息。gv$ 一般和 v$ 一起,直连数据库节点的时候,v$ 只能看到本机器,gv$ 是所有机器节点的信息。
问:OceanBase 数据库 4.0 版本,普通用户租户查看自己租户下所有的表,该查哪个视图?
答:先执行select distinct(OBJECT_TYPE) from DBA_OBJECTS;命令查询表类型。
后执行select OBJECT_NAME from DBA_OBJECTS where OBJECT_TYPE='table' ;命令根据表类型查表名。
问:执行
obd cluster list命令显示状态为destroyed的集群怎么清理删除?
答:cd ~/.obd/cluster,删除集群对应的 Name 目录。
问:社区版 OCP 开源的吗?
答:目前工具开放供下载使用,不开源,后续轻量版 OCPExpress 会考虑开源。
问:hint 中的 NO_USE_PX 是什么?
答:NO_USE_PX 指的是关闭并行查询。OceanBase 数据库 4.x 版本暂不支持关闭并行查询功能。
问:X86 版本 OCP 是否支持接管 ARM 版本的 OceanBase 数据库集群?
答:不支持混合接管和部署。
问:OceanBase 数据库支持 openeuler(欧拉)部署么?
答:暂未进行兼容适配,能部署但不保证运行后功能可靠性。
问:OceanBase 数据库一个表的分区大小是否有推荐大小?
答:OceanBase 数据库对分区大小未做限制,一般建议一个分区大小不要超过 100G,分区大小也可以按照磁盘空间和分区数预估。
问:proxy_sessid 和 server_sessid 之间的关系是什么?
答:proxy_sessid 唯一标识客户端和 OBProxy 之间的连接,server_sessid 唯一标识 OBPrxoy 和 OBServer 之间的连接。
问:OBClient 是不是没有 ubuntu/debian 系统的版本?
答:暂不支持,可使用 MySQL 客户端。
问:社区版 OMS 是否支持将 MySQL 数据库数据迁移到企业版 OceanBase 数据库的 MySQL 租户?
答:不支持。
问:OceanBase 数据库 4.0 版本怎么查看锁和事务的信息?
答:可在 DBA_OB_DEADLOCK_EVENT_HISTORY 中查看。
问:怎么查租户表占用磁盘空间大小?
答:仅查询基线数据的,转储合并后能看到最新的占用大小
OceanBase 数据库 3.x 版本可执行select tenant_id, svr_ip, unit_id, table_id, sum(data_size)/1024/1024/1024 size_G from __all_virtual_meta_table group by 1, 2, 3, 4;命令。
OceanBase 数据库 4.x 版本可执行select sum(size)/1024/1024/1024 from (select DATABASE_NAME,TABLE_NAME,TABLE_ID,PARTITION_NAME,TABLET_ID,ROLE from DBA_OB_TABLE_LOCATIONS ) AA full join (select distinct(TABLET_ID) ,size from oceanbase.GV$OB_SSTABLES ) BB on AA.TABLET_ID=BB.TABLET_ID where AA.role='leader' and AA.table_name='table_name';命令。
问:OceanBase 数据库 4.0 版本 TRUNCATE TABLE 支持指定分区清除数据吗?
答:支持,具体清理分区类型参见官网 OceanBase 数据库文档 Truncate 分区。
问:OBD 和 OBProxy 能和 OceanBase 集群部署在一起么?有什么性能影响?
答:可以,OBD 和 OBProxy 占用资源很少,业务量或者节点数不大情况下,几乎没什么性能影响。如果是大规模生产环境建议单独节点部署 OBProxy。
问:PHP 怎么连接 OceanBase 数据库?
答:[https://github.com/oceanbase/oceanbase/issues/841]。
问:执行
obd cluster destory命令销毁集群后能否再恢复?
答:不能,该操作直接删除物理数据文件,如果存在备份文件,可以新建集群备份恢复。
问:mysql-connector-java 的 8.x 版本怎么连接 OceanBase 数据库?
答:使用 MySQL Connector/J 8.x 版本连接 OceanBase 数据库时,Class.forName("com.mysql.jdbc.Driver")中的 com.mysql.jdbc.Driver 需要替换成 com.mysql.cj.jdbc.Driver。
问:是否有 JDBC 连接 OceanBase 数据库的配置示例?
答:conn=jdbc:oceanbase://x.x.x.x(ip):xx(port)/xxxx(dbname)?rewriteBatchedStatements=TRUE&allowMultiQueries=TRUE&useLocalSessionState=TRUE&useUnicode=TRUE&characterEncoding=utf-8&socketTimeout=3000000&connectTimeout=60000
问:社区版 OCP 支持 RHEL8 吗?
答:支持 RHEL7.2 及以上版本。
问:OceanBase 数据库是否支持主键修改?
答:3.x 版本不支持,4.x 版本支持。
问:Datax 的 ob writer 里 obWriteMode 支持 insert ignore 吗?
答:不支持,可以采用 insert into 或者 replace into 或者 ON DUPLICATE KEY UPDATE 语句。
问:如何查看所有的 SQL 记录?
答: OceanBase 数据库 3.x 版本可通过 SQL 审计视图 gv$sql_audit 查看。 OceanBase 数据库 4.x 版本可通过 SQL 审计视图 gv$ob_sql_audit 查看。
问:OceanBase 数据库 4.0 版本合并表信息是哪些?
答:major freeze 相关的信息放到了 **all_merge_info(用于存放租户合并的整体 merge 信息)、**all_zone_merge_info(用于存放租户下每个 Zone 的 merge 信息)表中。
**all_merge_info 表中有合并版本号、合并状态、是否发生了 error 等信息。 除了 sys 租户外,每个用户租户对应的 meta 租户下都有这两张表,用于保存该用户租户和 meta 租户的 merge 信息。也可以在 sys 租户下通过查看CDB_OB_MAJOR_COMPACTION来查看所有租户的 **all_merge_info 信息,通过查看CDB_OB_ZONE_MAJOR_COMPACTION来查看所有租户的 __all_zone_merge_info 信息。
OceanBase 数据库 4.0 支持对每个租户单独设置合并时间点,相关配置项为 major_freeze_duty_time,系统租户下可执行alter system set major_freeze_duty_time = 'xxx' tenant sys;语句设置。
问:OceanBase 数据库 4.0 版本为什么取消了轮转合并?
答:4.0 版本将合并拆分成了租户级,粒度更小,执行时间更短,因此取消了轮转合并。
问:如何手动杀掉正在执行 SQL?
答:执行show processlist;命令查看 ID 后执行kill $ID;命令。
问:怎么查看 OceanBase 数据库版本?
答:有多种方式查看,例如:
- selecet version();
- SELECT * FROM DBA_OB_SERVERS; -- 推荐
- 安装程序目录 ./bin/observer --version -- 推荐
问:OceanBase 数据库有哪些内存区域?
答:OceanBase 数据库中主要有以下内存区域:
- kv cache:LSM-Tree 中 SSTable 及数据库表模式等的缓存。
- memory store:LSM-Tree 中的 MemStore 的内存。
- sql work area:租户执行 SQL 过程中各个 Operator 工作区占用的内存,超出部分通常会走落盘流程。
- system memory:预留给 Net IO、Disk IO、Election 与负载均衡等各种功能的内存。
问:OceanBase 数据库的资源在租户中哪些是共享的,哪些是不共享的?
答:对内存而言,sql work area、memory store 与 kv cache 等资源为租户独享;system memory 为多个租户共享。对线程而言,sql worker 为租户间隔离;Net IO、Disk IO 与 Clog Writer 等资源为租户间不隔离。
问:OceanBase 数据库的内存使用有什么特征?
答:OceanBase 数据库在启动时会需要加载大约几个 GB 的内存,在运行过程中会逐渐按需进一步申请内存直至 memory_limit。而一旦 OBServer 节点向 OS 进行了内存申请,通常是不会释放或者返回给 OS,而是会维护在内存管理的使用列表和 Free List 当中。这个是 OceanBase 数据库设计上所建立的内存管理机制。
问:运行一段时间后,OceanBase 数据库使用内存接近 memory_limit 是否正常?
答:在 OceanBase 数据库的集群运行一段时间以后,内存消耗接近于 memory_limit 水平位置,且不发生降低的现象是符合预期的。 有一个例外是若设置了参数 memory_chunk_cache_size,OBServer 节点会尝试将 Free List 超过 memory_chunk_cache_size 的内存块还给 OS,增大 Free List 在 OceanBase 数据库内部的复用率,减少 RPC 由于内存操作慢而导致超时的风险。通常情况是不需要配置 memory_chunk_cache_size 的,在特定的场景下需要与 OceanBase 数据库 支持进行场景分析确定是否需要动态调整 memory_chunk_cache_size。
问:OBServer 节点的内存上限是否可以动态调整?
答:OBServer 节点的内存上限可以通过调整 memory_limit 或 memory_limit_percentage 来动态实现。需要注意的是调整前要检查内存资源是否够用,OBServer 节点内存上限目标是否已经低于了所有租户以及 500 租户的内存分配(租户建立时分配)的总和。memory_limit 的单位是 MB,例如,如果需要通过调整 memory_limit 参数来调整 OBServer 节点内存上限为 64G,可以通过语句 memory_limit ='64G' 或者通过 memory_limit = 65536 来指定。 另一方面,在使用 OBServer 节点的过程中,可能通过 memory_limit 来限制 OBServer 节点内存的生效参数。若将 memory_limit 设置为 0,还可以通过 memory_limit_percentage 以比例的形式更灵活地约束 OBServer 节点内存的使用情况。
问:在使用 OceanBase 数据库定义资源单元以及资源池时是否允许内存超卖?
答:在使用 OceanBase 数据库定义资源单元以及资源池时, Root Service 负责分配资源(Unit)。Root Service 在分配 Unit 的时候会根据 resource_hard_limit 来决定内存是否可以超卖 (resource_hard_limit 表示内存超卖的百分比,大于 100 表示允许超卖),Root Service 再具体分配资源的时候还会按照 Unit 本身定义的资源单位来进行分配。 但是在通常情况下,如果资源相对来说比较紧张,系统不同的租户负载可以有控制地交错运行,配置租户时有可能会对 CPU 资源进行超卖。如果 CPU 超卖生效,OceanBase 集群在运行过程中会产生负载过载等情况,那么不同租户间会产生线程竞争 CPU 的现象,直接导致的结果是租户实际业务场景变慢。若是内存配置成超卖场景,虽然在创建租户时租户规格总和可以超过 memory_limit,但实际使用时 OceanBase 数据库的内存使用还是会受到 memory_limit 约束。比如在运行中的租户消耗的内存总和将要超过 memory_limit,租户会报内存超限问题甚至进程直接 OOM。
问:使用 OceanBase 数据库在开发中要特别注意什么?
答:以下列出开发过程中的注意事项,仅供参考:
- 大数据量导入需要特别关注内存的使用情况。
- 索引生效时间较长,建议在建表时将索引语句一并纳入。
- 表建好后,主键不能更改。如果需要修改,只能删表重建。
- mysql-connector-java 的版本建议使用 5.1.30 及以上。
- 列类型修改有较大限制。Varchar 长度只能由短变长,不能由长变短。
- 如果一个连接超过 15 分钟空闲,服务端会主动断开,在使用连接池的时候需要设置一个连接最大的空闲时间。例如,Druid 的 minEvictableIdleTimeMillis 小于 15 分钟。
问:什么是实例,什么是租户,它们的关系是什么?
答:OceanBase 数据库是一个多租户系统, 一个实例即 OceanBase 集群中的一个租户。 租户之间的数据不能互相访问。
问:OceanBase 数据库的性能和机器数量的关系是什么?
答:从 OceanBase 数据库的 TPC-C 报告中显示,相同场景下的基本都是线性扩展的。
问:数据文件对应哪个级别的数据库管理?
答:OceanBase 数据库中目前有两类数据文件,且两类数据文件均属于集群级别:
- Data 文件:保存各个分区的数据,包括各个分区的 Checkpoint 点。
- Clog 相关:包含 Clog(也称为 Redo Log 或 WAL 日志) 和它的索引文件。
问:
ERROR 1045 (42000): Access denied for user 'xx'@'xx.xx.xx.xx' (using password: YES)
答:填写了密码,但无法访问数据库。
- 密码不正确。
- 不在集群访问白名单中。
- 集群处于初始化节点,未启动完成,可能是资源不足导致。
问:
ERROR 1045 (42000): Access denied for user 'xx'@'xx.xx.xx.xx' (using password: NO)
答:没填写密码,无法访问数据库。
- 没有填写密码。
- 密码 proxyro_password 为空且和 observer_sys_password 未保持一致。
问:
ERROR 1049 (42000): Unknown database 'oceanbase123'
答:-D 指定的库不存在。
问:
ERROR 2002 (HY000): Can't connect to MySQL server on 'xx.xx.xx.xx'
答:无法连接到数据库。
- -P 登录端口不正确。
- 所连接 IP 节点不存在 OB 数据库服务。
- 防火墙/安全策略禁止访问等。
问:
ERROR 4669 (HY000): cluster not exist
答:-u 参数里的集群名称不存在。
问:
ERROR 4012 (HY000): Get Location Cache Fail
答:-u 参数里的租户信息不存在。
问:旁路导入时 need_sort 排序参数的作用?
答:数据本身是有序的,就设置 false,如果是无序的就设置 true,可以加快导入速度,如果设置了 need_sort = false,但是导入数据又是无序的,那么旁路导入内部会检测出来并报错。
问:clog 目录下的 log_pool 是做什么的?
答:log_pool 是 ob 的日志池化,根据 log_disk_size/64M 创建出多个 log_file,当 ob 需要记录 redolog 时,需要从 log_pool 里申请 log_file,简单理解就是日志盘预分配池,不能删,删除了可能会导致日志盘的空间不足或者一些非预期的异常。
问:如何删除 OCP 下的监控数据?
答:monitor 租户的数据不推荐手动删除,可以在 OCP 系统参数中搜索关键字 retention 进行调整,会自动清理,注意部分参数需要带上单位。
问:ocp-express 上显示每个 observer 的 cpu 使用率比较高,但租户的 cpu 使用率很低?
答:没有开启 cgroup 时,目前监控上的 cpu 使用率是指线程使用率,不表示物理 cpu 使用率。租户运行时要维持恒定量的活跃工作线程,这个数量是 mincpu * cpuquota_concurrency 来控制的。租户上有时会挂起一些处理慢查询的线程,同时要分配新的线程以维持活跃线程数恒定,这时用 max_cpu * workers_per_cpu_quota 限制租户总共持有的线程数上限。
问:创建了 tablegroup 不生效?
答:首先 OB4.2 版本才支持 tablegroup,修改 tablegroup 之后,要等 partition_balance 触发才会变更表组内各表分布。分区均衡通过调配置项 partition_balance_schedule_interval 可以触发。
问:OB4.x 查看索引状态?
答:select count(*) from cdb_objects where status<>'VALID' and object_type in ('INDEX','INDEX PARTITION');或者select * from cdb_indexes where status<>'VALID';
问:OB4.x 版本怎么查询分区数?
答:可以从不同维度查询分区数信息。
- 总表个数
select count(*) from cdb_OB_TABLE_LOCATIONS;- 租户在各个节点主分区个数
select count(*),svr_Ip from cdb_OB_TABLE_LOCATIONS where tenant_id=1001 and role='leader' group by svr_ip;- 统计分区最多的 10 个租户
SELECT t2.tenant_name,t2.tenant_id, t1.replica_count FROM (SELECT con_id, COUNT(*) AS replica_count FROM CDB_TAB_PARTITIONS GROUP BY con_id ORDER BY replica_count DESC LIMIT 10) t1 JOIN (SELECT tenant_id, tenant_name FROM __all_tenant) t2 ON t1.con_id=t2.tenant_id ORDER BY replica_count DESC;
问:怎么确认 outline 绑定 hint 生效了?
答:通过select outline_id from gv$ob_plan_cache_plan_stat where query_sql like '%sql语句关键字信息%';outline_id 如果返回非-1 ,则表示 outline 生效。
问:OB 有一些参数或者变量在集群或者租户创建好后不允许修改,哪些是只读的?
答:参数:select svr_ip, name,value from gv$ob_parameters where edit_level='readonly';变量:源码文件cat src/share/system_variable/ob_system_variable_init.json | jq ".[] | {name,flags}" | grep -C 2 "READONLY" | grep -v "ORACLE_ONLY"
问:执行 sql 报错:
Error 5930: maximum open cursors exceeded。
答:open_cursors 默认设置为 50,可以调大改参数,ps 协议执行 sql 也会占用 open_cursors 数,建议设置 500,按需逐渐调大。
问:统计租户的大小的 sql?
答:select t.tenant_name, round(sum(t2.data_size)/1024/1024/1024,2) as data_size_gb, round(sum(t2.required_size)/1024/1024/1024,2) as required_size_gb from dba_ob_tenants t,cdb_ob_table_locations t1,cdb_ob_tablet_replicas t2 where t.tenant_id=t1.tenant_id and t1.svr_ip=t2.svr_ip and t1.tenant_id=t2.tenant_id and t1.ls_id=t2.ls_id and t1.tablet_id=t2.tablet_id -- and t1.role='leader' group by t.tenant_name order by 3 desc;
问:统计库的大小 sql?
答:select t1.database_name, round(sum(t2.data_size)/1024/1024/1024,2) as data_size_gb, round(sum(t2.required_size)/1024/1024/1024,2) as required_size_gb from dba_ob_tenants t,cdb_ob_table_locations t1,cdb_ob_tablet_replicas t2 where t.tenant_id=t1.tenant_id and t1.svr_ip=t2.svr_ip and t1.tenant_id=t2.tenant_id and t1.ls_id=t2.ls_id and t1.tablet_id=t2.tablet_id -- and t1.role='leader' and t.tenant_name='test1' group by t1.database_name order by 3 desc;
问:统计表/索引的大小的 sql?
答:select t1.table_name, round(sum(t2.data_size)/1024/1024/1024,2) as data_size_gb, round(sum(t2.required_size)/1024/1024/1024,2) as required_size_gb from dba_ob_tenants t,cdb_ob_table_locations t1,cdb_ob_tablet_replicas t2 where t.tenant_id=t1.tenant_id and t1.svr_ip=t2.svr_ip and t1.tenant_id=t2.tenant_id and t1.ls_id=t2.ls_id and t1.tablet_id=t2.tablet_id -- and t1.role='leader' and t.tenant_name='test1' and t1.database_name='sbtest' and t1.table_name='sbtest1' group by t1.table_name order by 3 desc;
问:统计表对应的分区大小的 sql?
答:select t1.table_name,t1.partition_name, round(sum(t2.data_size)/1024/1024/1024,2) as data_size_gb, round(sum(t2.required_size)/1024/1024/1024,2) as required_size_gb from dba_ob_tenants t,cdb_ob_table_locations t1,cdb_ob_tablet_replicas t2 where t.tenant_id=t1.tenant_id and t1.svr_ip=t2.svr_ip and t1.tenant_id=t2.tenant_id and t1.ls_id=t2.ls_id and t1.tablet_id=t2.tablet_id and t1.role='leader' and t.tenant_name='test1' and t1.database_name='sbtest' and t1.table_name='sbtest1_part' group by t1.table_name,t1.partition_name;
问:ocp-agent 或者 ocp-monagent 服务定时重启?
答:OCP403 版本缺陷,建议升级 OCP421 最新版本。
问:使用不符合 only_full_group_by 的 SQL 语法查询结果集不一致?
答:符合预期,原生 mysql 也有同样的风险,ob 默认的 sql_mode 虽然未强制遵循 only_full_group_by,但建议用户按标准 sql 语法使用。
问:unit 迁移怎么提高并发度或者迁移速度?
答:可以调整 ha_mid_thread_score 参数。
问:OCP421 版本部署 obproxy 时,负载 OBLB 无法使用?
答:OCP 社区版不支持 OBLB 功能。
问:为什么普通租户查看 DBA_OB_LS 视图表比 sys 租户返回的还多?
答:DBA_OB_LS 可以看到当前租户的日志流信息,而系统租户默认只有一个日志流。
问:AP 业务经常遇到租户内存不足报错:
No memory or reach tenant memory limit
答:调整 ob_sql_work_area_percentage 参数,增加 sql 工作区的内存比,默认是 5%,一般 AP 比 TP 对内存的需求要大一点。
问:为什么数据目录只有一个 block_file 文件?
答:类似 oracle 的 segment 管理,最终都是通过宏块/微块组织的,一个 block_file 可以理解为一个盘,底层存储自己来管理使用这块盘,多个文件并没带来什么收益。
问:如何看 block_file 文件中的不同租户、表的 sstable 布局?
答:先找到表的分区 tablet_id(CDB_OB_TABLE_LOCATIONS),然后查__all_virtual_tablet_sstable_macro_info 过滤 tablet_id,会列出所有的宏块。可以通过表中的宏块的 macro_logic_version 和 GV$OB_SSTABLES 中 sstable 的 end_log_scn 来对应宏块和 sstable 的关系。
问:如何获取如果获取微块 micro_id?
答:知道宏块 id 后,可以使用 dumpsst 来 dump 出宏块信息,里面会包含微块信息。
问:创建 resource unit 资源单元时,内存和 CPU 的比例推荐?
答:基于当前大型生产环境提供的配比经验,一般初始按 CPU:MEMORY=1:2 或 1:4 比例,后期再根据业务需要进行调整。
问:OCP 的 Unit 迁移中目标端地址不显示内容?
答:unit 迁移只在 zone 内发生,不同 zone 之间的属于扩容缩容。
问:obclient 怎么输出更多执行信息?
答:增加 -v 或者 -vv 参数打印详细信息。
问:OB4.x 支持使用密文密码创建用户吗?
答:支持。
问:如果针对单 sql 设置查询超时?
答:使用hint select /*+ QUERY_TIMEOUT (10000000) */注意,obclient 连接时需要加 -c 参数。
问:OceanBase 的 update 操作在 memtable 中什么操作?
答:主表是 update,如果有修改索引列,索引表是 delete+insert。
问:observer 之间可以加密传输吗?
答:开启 RPC 安全认证就可以,但是会有性能回退,酌情选择。alter system set ssl_client_authentication=true;
alter system set rpc_client_authentication_method='SSL_IO';
alter system set rpc_server_authentication_method='SSL_IO';
问:解除主备租户关系后,怎么删除备份源?
答:alter system set log_restore_source='' tenant = '$tennant_name';设置日志源为空即可。
问:是否支持无锁结构变更,offline DDL 转 online DDL。
答:ODC 工具支持影子表的方式进行无锁结构变更。
问:OB 的索引碎片化问题怎么处理的?
答:OB 基本不存在索引碎片化,每天都会做合并,重新组织数据。
问:OB 的归档和备份为什么需要使用 NFS 或 OSS 介质?
答:单机且测试场景可以使用本地目录,集群或者生产环境需要使用介质,因为所有节点都需要访问公共的备份目录,数据在一个目录才可以做集群恢复。暂时没有多节点本地备份,汇总恢复的功能。
问:创建分区表,怎么确认需要创建多少个分区?
答:单个 server 不建议超过 3 万个分区总数,分区表的每个单分区不建议超过 200G,推荐 100G。
问:OceanBase 支持 Cognos 连接吗?
答:暂时不支持。
问:OB 为什么不建议数据和日志同盘?
答:底层存储引擎, 因为下面 3 个原因, 采用了提前预占用磁盘空间的设计。
为了更好的获取 io 性能:
底层存储引擎提前将磁盘空间申请下来, 并采用 mmap 技术, 将部分空间映射起来, 能获得更快的磁盘性能。
另外有一些文件 io 操作, 可以提前做, 减少 io 指令, 提升性能。
多块盘, 能提供更多的并发能力。
- 增强系统的稳定性, 提前将磁盘占住, 避免被一些其他的程序将磁盘空间消耗掉, 导致存储引擎申请磁盘空间出错, 导致一系列的问题。
- 部分场合下可以减少硬件成本. 更快的盘(更贵的盘)可以用于 clog, 更大容量或稍慢一点(更便宜的盘) 用于 data 盘。
从运维角度更安全,曾经发生过的故障: 用户将 clog 盘和 data 盘共用, 刚开始的时候, 磁盘空间能支撑业务, 随着业务量增大, data 的文件大小设置小了, 用户赶紧把 data 文件大小 datafile_size 调大, 一不小心, 忘记了 data 和 clog 共用一个盘, 导致 data 侵占了 clog 的空间, 最后导致 clog 写日志失败, observer 处在只读状态。 同时分盘部署, 能减少运维的故障风险。
问:gv$sql_plan_monitor 这个视图什么情况下会生成数据?
答:三种情况可以看到数据:
- 如果 query 执行时间超过 3s,会有数据;
- 或者加上 /*+ monitor */ 这样的 hint,例如:
select /*+ monitor */ * from t1; - 或者是并行 SQL,比如:
select /*+ parallel(3) */ * from t1;
问:DDL 语句执行 1000s(16 分钟)报错超时?
答:隐藏参数 _ob_ddl_timeout 控制。和数据量相关的 ddl 的超时时间可以理解成无穷大(实际被设成了 102 年),不受 _ob_ddl_timeout 的控制,像这类追加索引、追加外键、追加 check 约束这类比较特殊的 ddl,超时时间也不受 _ob_ddl_timeout 的控制。
问:OB4.x 转储合并会对 DML 有影响吗?
答:转储前会先冻结 memtable,后续的 DML 会在新的 memtable 上进行,并不会有影响。 至于转储如果卡住了,内存会无法释放,当持续的 DML 把内存吃满后,会导致 DML 执行失败。
问:执行 sql 报错内存不足和 ob_sql_work_area_percentage 参数有什么关系?
答:ob_sql_work_area_percentage 是租户的工作区内存占租户内存的百分比,工作区内存,是指 SQL 排序等阻塞性算子使用的内存,通过租户系统变量,默认值是租户内存的 5%,如果请求并发量较大,且每个请求占用的工作区内存比较多,可能出现工作区内存不足的报错,经常出现的场景有 union、sort、group by 等。上述问题如果出现,可以通过适当调大系统变量或者调大租户的内存来规避。
问:OB4.x 能限制租户级别的数据磁盘使用空间吗?
答:目前不可以,集群的 data 盘是所有租户共用的。
问:OBKV 场景,数据流中并未有 I/U 的标识,分段拉取,是否可以只使用 insert 实现最终大宽表的数据模型?
答:大宽表模型的话可以直接使用我们的 hbase 客户端实现。如果是 table 模型,不确定是 insert 还是 update,可以使用 table 客户端的 insertOrUpdate 接口。
问:OB4.x 使用 truncate 表后不会进回收站?
答:OB3.x 版本支持 truncate 表回收,OB4.x 暂时不支持。
原理
问:OceanBase 数据库的索引采用的是哪种方式?
答:MemTable 使用的是 B+ 树结构,而 SSTable 使用的是宏块结构。
问:plan cache 分配资源过少或者大并发会造成 plan cache 命中率较低的问题吗?
答:根据资源和并发情况分为如下几种情况讨论。
- 资源少的情况下需要看流量
- 如果流量一直只是一个 query,那么这个 plan 将一直存在 plan cache 中,而且一直命中。
- 如果流量是多种多样的 query,那么由于资源分配有限,plan 将会发生频繁汰换,最终分配资源过少会导致 plan cache 命中过低的。
- 并发量大导致内存快速写满会造成 plan 的频繁汰换,这将导致计划命中率降低。但是需要注意的是并发量大不一定会导致 plan cache 命中率降低,只要汰换率没有上去,命中率也不会降低。
问:租户 MemStore 使用达到阈值后,选择合并或者转储的依据是什么?
答:有自动转储和手动转储两种转储方式。有自动合并、定时合并与手动合并三种合并方式,如果自动合并过程中失败了,除了个别错误外,会一直重试。合并在默认情况下是以每日合并的方式定时触发的。
- 自动转储是当 MemStore 使用达到预设的限定时,例如 MemStore 内存使用率大于
memstore_limit_percentage * freeze_trigger_percentage的值,自动触发冻结 + 转储,转储为 mini sstable 后根据 minor_compact_trigger 来触发 mini minor 或 minor 。- 手动转储是手动执行
alter system minor freeze;进行转储。
问:parallel_servers_target 并发参数怎么理解?
答:parallel_servers_target 这个指标都是针对 px 类型的 SQL 进行约束的,当超过这个阈值,阻塞的是后续的 px 类型 SQL 的执行,不阻塞本地 SQL 的执行。也就是并发 SQL 不会占用所有线程,会给普通 SQL 预留一些线程资源。所以 parallel 数量的设置应该根据需求和资源来确定,如果全都设成并发 SQL,就会互相阻塞。
问:用户的 SQL 请求和 RPC 之间有什么关系?
答:OBServer 节点之间沟通使用的是 RPC 2882 端口,最简单的以广播查询 SQL,是建立一张分区表,但是 SQL 语句不带分区键,用户执行 SQL 是发到了一台 OBServer 节点机器上,但是分区表的各个分区的主副本是在多台 OBServer 节点机器上的,需要将 OceanBase 数据库接收 SQL 的请求拆分,调用各个分区主副本所在的 OceanBase 数据库获取数据,然后再聚合后返回给用户。
问:GLOBAL 的变量会持久化到什么地方?
答:仅 GLOBAL 级别的变量会持久化,SESSION 级别的变量不会进行持久化。持久化到内部表与配置文件,可以在 /home/admin/oceanbase/etc/observer.config.bin 与 /home/admin/oceanbase/etc/observer.config.bin.history 文件中查询配置项
问:OceanBase 数据库 4.0 版本中,GV$OB_SERVER_SCHEMA_INFO 视图中的 SCHEMA 是什么?
答:Oceanbase 数据库的 schema 泛指一切需要在集群范围内同步的数据库对象元信息,包括但不限于 table、database、user 等元信息。此外 Oceanbase 数据库的 schema 是多版本且各租户独立,在集群范围同步是最终一致的。
GV$OB_SERVER_SCHEMA_INFO 可以理解为每台 OBServer 节点机器中每个租户已经刷新的最新版本的 schema 的信息,这个视图用户比较关注的 schema 信息是 REFRESHED_SCHEMA_VERSION、SCHEMA_COUNT、SCHEMA_SIZE,其含义如下。
- REFRESHED_SCHEMA_VERSION:对应租户在对应机器已刷新到的 schema 版本。
- SCHEMA_COUNT:对应 schema 版本下,各 schema 对象数目的总和。
- SCHEMA_SIZE:对应 schema 版本下,各 schema 对象总共所占的内存大小(单位 B)。
问:执行计划中的 px partition iterator,px block iterator 是什么意思?
答:partition iterator 是以分区粒度迭代数据,block iterator 是以 block 粒度迭代数据,Iterator 是对数据的抽象,它把数据抽象成一块一块的,以便多个线程并发地处理这些数据。一块数据如果对应的是一个分区,则是 partition iterator。一块数据如果对应的是一个或数个宏块,则是 block iterator。
问:OceanBase 数据库是如何创建索引,不影响更新操作的?
答:OceanBase 数据库在创建索引的时候,是一个渐进的过程,首先不影响写入,因为 OceanBase 数据库是追加写。对于索引列有更新的情况,会进行记录。然后会去扫描现有数据去创建索引,扫描完成之后将更新的和新增的数据做一次合并,最后再将索引标记为可用状态,就完成了索引的创建。
问:OceanBase 数据库 4.0 版本生产环境最小磁盘使用空间限制为什么是 54G?
答:54G 是目前计算出来 OceanBase 数据库启动需要的空间,下面是计算公式。
slog 统计规则:slog 统计 10G,目前是硬编码,有计划优化到 2G、4G 左右。
SSTable 统计规则:空集群启动后转储合并实测大概会有 1G 磁盘开销,代码没有针对 SSTable 做限制,但是按照长稳运行需要 20G。
clog 统计规则如下。
- 理论最小值:新建一个租户预期需要创建 4 个日志流,每个日志流目前空间需求最低 512M,这里算出需要的最小磁盘是 2G。
- 用户设置值:系统租户:取 max(2G,用户设置);普通租户:取 max(2G,所在盘全部)。
- OBD 计算:根据 OceanBase 数据库最小规则(4C8G)计算,即 8 * 3 = 24,其中 3 为 OceanBase 数据库中 4.x 中对于 clog 内存和磁盘占用的大概估算。
所以目前,选了 24G+10G+20G = 54G 作为启动最小依赖的内存,不过后续有优化的计划。
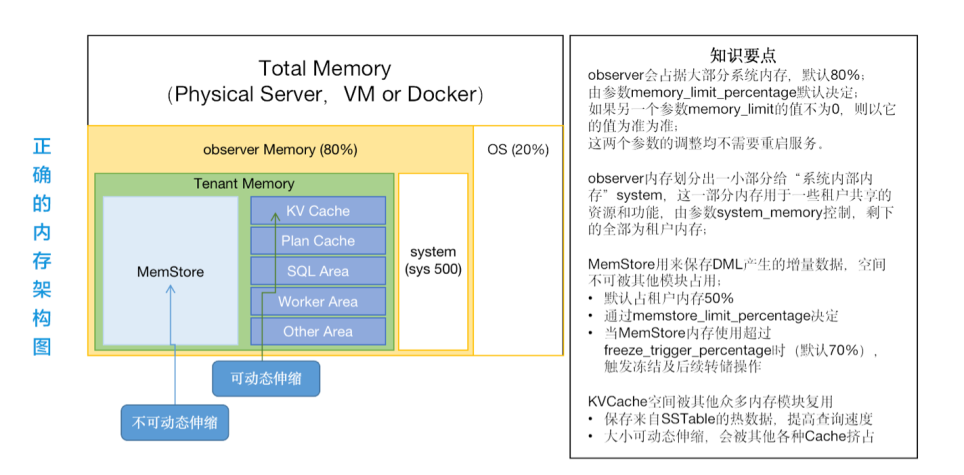
问:OceanBase 数据库内存是怎么规划的?
答:
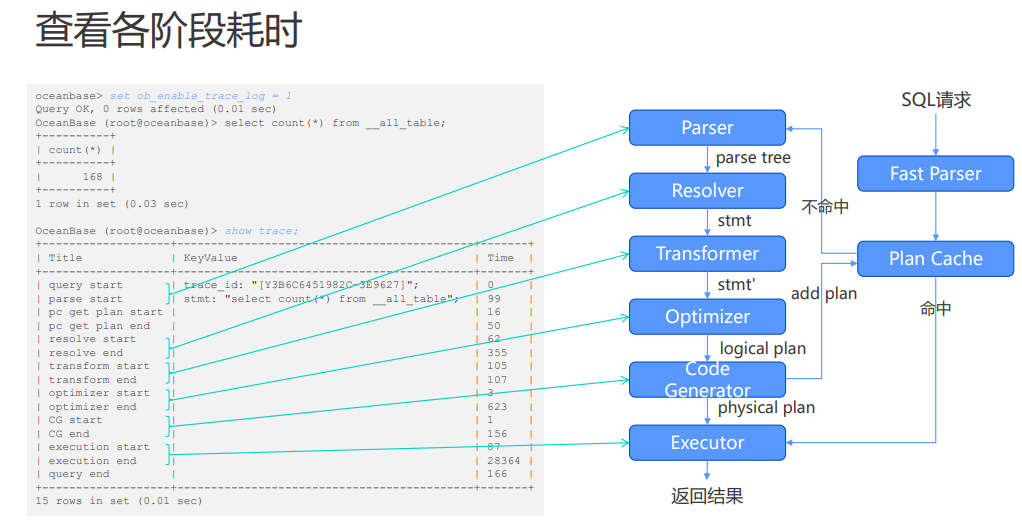
问:OceanBase 数据库中 SQL 执行流程
答:>
问:sql_audit 性能视图中各个字段表述的含义?
答:参看文章:https://open.oceanbase.com/blog/6621094960?_gl=1*5whfs0*_ga*ODQzNDgzMjU4LjE2NjM1NzU0MjE.*_ga_T35KTM57DZ*MTcwNDE4MTM5OC4xNzAzLjEuMTcwNDE4MjMxNi40My4wLjA
问:OB4.x 版本 medium_merge 的合并策略是什么?
答:建议看源码 ObAdaptiveMergePolicy 类,这里简单介绍下。 medium_merge 的触发条件基于一些按分区收集的写入、查询、数据操作类型等方面的信息,经过某些策略计算后判断是否触发。 简单说分为以下几个场景: LOAD_DATA_SCENE = 1, -- 导数场景,转储多且插入多 TOMBSTONE_SCENE = 2, -- 删除、更新多场景 INEFFICIENT_QUERY = 3, -- 慢查询多场景 FREQUENT_WRITE = 4, -- 新增数据量多
问:memtable 中的 transnode 压缩是什么?
答:将多个 transnode,如多个 update 整合到一个 TransNode,得到一个集合了这些 update 的 update 行,和 compact 过程有点类似。
问:SUBPLAN SCAN 与 SUBPLAN FILTER 算子分别会在什么情况下生成?
答:当读视图中的内容时,执行计划中会分配 subplan scan 算子;类似地,读实体表就会分配 table scan 算子。 SQL 在优化器里首先会被改写,如果改写之后还是一个子查询,那么就会生成 SUBPLAN FILTER 算子,用于驱动子查询的计算;如果非相关子查询被改写成了等价的 JOIN,就不会生成 SUBPLAN FILTER 算子了。
问:SUBPLAN SCAN 与 SUBPLAN FILTER 算子的区别是什么?
答:SUBPLAN FILTER 的算子功能是驱动表达式中的子查询执行,以 nested-loop 算法执行去 subplan filter 算子。如果是相关子查询,执行时每从左边取一行数据,然后就会执行一遍右边的子计划;如果是非相关子查询,还是从左边逐行取数据,不过右边的子计划实际只会算一次。
问:tablet 的作用?
答:tablet 是分片,具备存储数据的能力,支持在机器之间迁移(transfer),是数据均衡的最小单位。分区包括多个分片,sstable 是基线数据,会包含多个 tablet.分区分裂和合并根据分区规则。最简单情况下,可以认为一个分区对应一个 Tablet,一个 Tablet 对应一个 SSTable。更多复杂情况下,这都不一定,对应关系会比较复杂。
报错
问:oblogproxy 的 config.setTableWhiteList(“sys.abc.*”) 如何设置指定表的信息?
答:使用|分隔符,例如sys.abc.tableA|sys.abc.tableB。
问:OceanBase 数据库 V3.1.0 升级到 V3.1.4 版本失败?
答:OceanBase 数据库 V3.1.0 不支持本地升级,只能做数据迁移逻辑升级,并且 3.x 版本不支持直接升级至 4.x 版本。
问:报错 OceanBase 数据库 D-1006: Failed to connect to oceanbase-ce 的原因是什么?
答:有如下几种情况。
- OBD 和目标机器之间网络不连通。
- 对应的组件进程已经退出或者不提供服务。
- 账号密码不匹配。
- OceanBase 数据库日志磁盘不足。
问:报错
oceanbase-ce's servers list is empty的原因是什么?
答:检查部署配置文件 oceanbase-ce 模块下的 servers 中 ip 格式是否填写正确。
问:使用 OBLOADER 导入数据失败,未返回报错怎么办?
答:OBLOADER 默认的行为是:运行错误日志记录在 logs/ob-loader-dumper.error,具体错误的记录会记录在 logs/ob-loader-dumper.bad。
如果要求遇到错误快速失败,可以指定 --max-errors 选项。
问:OCP 界面无操作退出登陆,怎么设置超时时间?
答:默认是 30m 无操作退出,可在 OCP 系统参数中设置 server.servlet.session.timeout。
问:OCP 上集群状态显示运维中?
答:“任务”中可能有任务在执行或执行失败。
问:用 benchmarksql 导入数据时,出现如下 3 类错误。
- Worker 089: ERROR: Failed to init SQL parser
- Worker 044: ERROR: No memory or reach tenant memory limit
- Worker 083: ERROR: Internal error
答:首先看下相关日志文件,如 benchmarksql.log。
- 确认使用的租户,因为 sys 租户内存太小,很可能不够用,所以不建议使用 sys 租户。 可通过命令
select a.tenant_id,max(tenant_name), round(sum(used)/1024/1024/1024,2) “mem_quota_used(G)” from gv$memory a, __all_tenant b where a.tenant_id=b.tenant_id;查询,如果查询结果 tenant_id > 1000 则是普通租户,这样可以判断租户的情况。- 如果是普通租户,查看 memory_limit 的值是不是太小,建议调大些。
- 查看 props.ocenbase 配置文件,里面配置了很多测试的配置信息,比如数据库,仓库数等等。props.oceanbase 文件中参数 warehouses 和 loadWorkers 的值需要修改成较小的值,然后登录(用 user 参数值登录),再测试一下,如果没问题,说明测试资源不足,可能是租户资源,也可能是机器资源有问题,此时可以参考租户资源和机器配置分析原因。
问:使用 myloader 想 OB4.2 导入数据报错:Cannot parse integer value "-u" for -P
答:需要在 -u,-P,-p 参数 后增加空格,例如:-u test -P 2881 -p "123"。
问:ubuntu 系统下 obclient2.2.2 版本无法使用方向键和退格键。
答:obclient2.2.3 修复,或者使用 mysql 客户端。
问:关于展示物理恢复租户、备租户的日志恢复源的视图 CDB_OB_LOG_RESTORE_SOURCE 中的 RECOVERY_UNTIL_SCN 字段为日志获取上限,为什么会有上限?
答:RECOVERY_UNTIL_SCN :表示租户可恢复到的终点,如果值为 4611686018427387903 ,则表示恢复到无穷。 如果 RECOVERY_UNTIL_SCN 为某个指定的值(非 4611686018427387903 ),则当租户的同步位点 SYNC_SCN 与租户可恢复到的终点 RECOVERY_UNTIL_SCN 相等时,租户不再同步日志。
故障恢复
问:服务器硬件故障或者需要长时间停止某个节点或某个 Zone,怎么操作?
答:需要调整 server_permanent_offline_time 参数,防止被永久下线。默认是 1 小时。该配置项的适用场景及建议值如下。
- OceanBase 数据库版本升级场景:建议将该配置项的值设置为 72h(OCP 升级 OceanBase 数据库可忽略,默认会调整)。
- OceanBase 数据库硬件更换场景:建议手动将该配置项的值设置为 4h。
- OceanBase 数据库清空上线场景:建议将该配置项的值设置为 10m,使集群快速上线。
问:创建分区表报错
Too many partitions (including subpartitions) were defined?
答:有如下两个原因。
- 超出单表最大分区数限制(8192 个)。
- 租户内存不足。
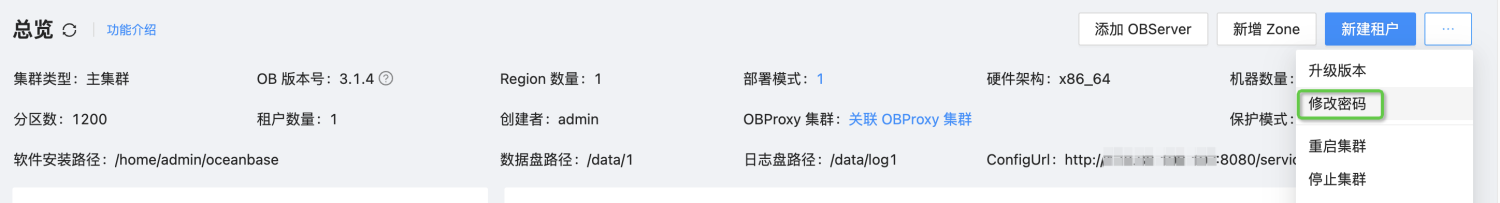
问:系统租户 root@sys 用户密码忘记了?
答:根据部署方式的不同有两种方法。
- OCP 部署时可对应集群总览界面 - 修改密码。
- OBD 部署时可执行
obd cluster edit-config 部署名称命令查看配置文件中的密码信息。
问:OMS4.x 如何跳过 DDL 操作?
答:目前 OMS4.x 已支持界面操作跳过 DDL,前提是增量同步报错后,人为界面确认并跳过,且并非所有 DDL 都支持跳过。手动跳过方式如下: 查看组件监控 -> 更新 Incr-Sync 组件 -> skipDdl 项 跳过 1 个 ddl 写法:["create table a as select * from b"] 跳过多个 ddl 写法:["create table a as select * from b","create table c as select * from d""] 跳过包含关键字的 ddl 写法:["utf8mb4_unicode_ci"] 表示增量中跳过所有包含 utf8mb4_unicode_ci 关键字的 DDL 语句。
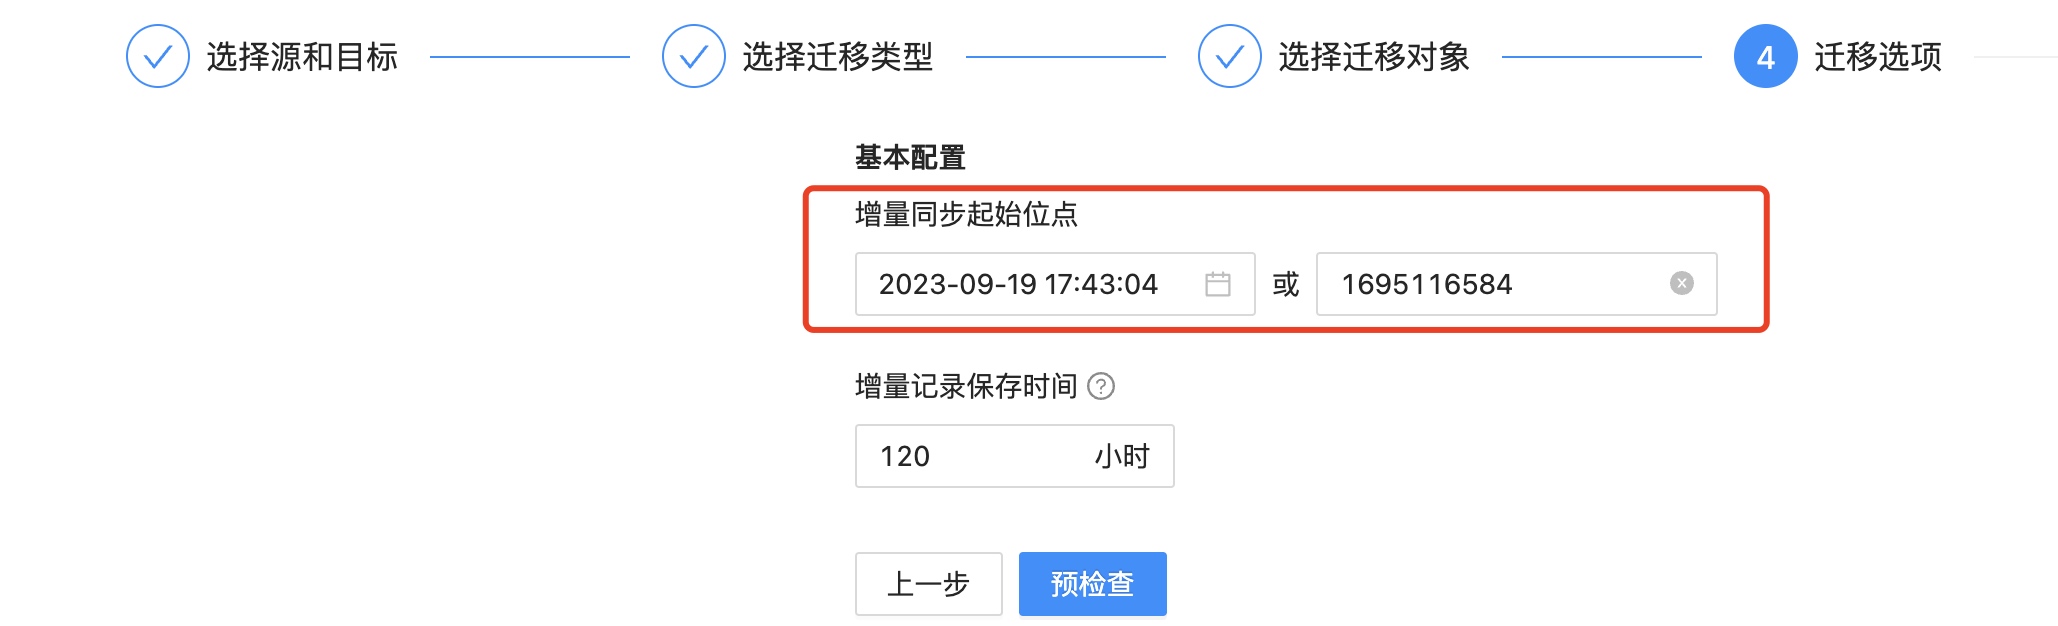
问:OMS 增量同步点位配置方法?
答:分为 2 种场景,OMS4.1.1 之前版本和 OMS4.1.1 以及之后版本配置方式
OMS 4.1.1-CE 及以后版本,迁移链路选择增量同步时,前端页面可以直接调整增量同步位点。
OMS 4.1.0-CE 版本,前端页面无法选择 增量同步起始位点,修改方法如下:
- 运维监控 -> 组件 -> store -> 新增 -> 填写同步起始点位。
- 再通过迁移链路停止原来迁移链路的 store 组件。
问:在别的服务器上重新部署了 OBD,怎么把原来的 OBD 集群信息接管?
答:可以把原部署的 obd 用户上的~/.obd/上的信息复制到新的环境上~/.obd/下(obd 的部署用户需要保持一致),同时需要保证免密等操作的一致性。
问:OCP 管理的 OB 数据磁盘预占用太大,也无法扩磁盘,怎么办?
答:OB 的数据磁盘参数 datafile_size 和 datafile_disk_percentage 是不支持缩小的,一旦预占用太大,特别是同盘场景,其他文件占用磁盘后,会出现磁盘空间不足等问题,影响集群正常使用。多节点集群环境是可以通过节点替换方案轮询重装单节点重新设置数据盘大小的。单机可以部署新环境,采用数据导出导入/ODC 数据归档/OMS 数据迁移/备份恢复/主备租户方式恢复数据。以下以多节点集群方案后台操作方式调整流程。该方法使用限制: 仅适用于 OB 集群环境,单节点禁止使用。 用户部署 OB 的时候 datafile_size 或者 datafile_disk_percentage 采用默认值,后续觉得太大,datafile 参数不支持调小。
4.x 确认 data/clog disk 使用情况
select zone,svr_ip,svr_port, round(log_disk_capacity/1024/1024/1024,2) as log_disk_capacity_gb, round(log_disk_assigned/1024/1024/1024,2) as log_disk_assigned_gb, round((log_disk_capacity-log_disk_assigned)/1024/1024/1024,2) as log_disk_free_gb, round((data_disk_capacity/1024/1024/1024),2) as data_disk_gb, round((data_disk_in_use/1024/1024/1024),2) as data_disk_used_gb, round((data_disk_capacity-data_disk_in_use)/1024/1024/1024,2) as data_disk_free_gb from gv$ob_servers;3.x 确认 disk 使用情况
select svr_ip,svr_port, round(total_size/1024/1024/1024,2) as total_size_gb, round(used_size/1024/1024/1024,2) as used_size_gb, round(free_size/1024/1024/1024,2) as free_size_gb from __all_virtual_disk_stat ;通过上面的 sql 可以评估实际数据占用的磁盘大小,如果实际使用量小,可以采用重建节点来减小 datafile 大小。
确认要 delete server 的节点上涉及的租户:
select tenant_id,tenant_name from dba_ob_tenants where tenant_id in (select tenant_id from dba_ob_units where svr_ip='xxx');确认要 delete server 所属的 zone:
select svr_ip,zone from gv$ob_units where tenant_id=xxx and svr_ip='xxx';调整租户的 locality:
alter tenant test2 locality="F@zone1,F@zone2";确认 locality 是否执行完成:
select * from DBA_OB_TENANT_JOBS where sql_text like 'alter tenant test2 localit%';说明: enable_rereplication=true,对应的租户 ls_gc_delay_time 默认是 1 小时 gc,可以调小加快日志流 gc。
调整租户的 resource pool list:
select * from dba_ob_resource_pools where tenant_id=xxx and zone_list='xxx';>alter tenant test2 resource_pool_list=('pool_test2_zone1_dgu', 'pool_test2_zone2_brw');删除 resource pool:
drop resource pool xxx3;说明: 如果要删除的 resource pool 在多个 zone 上存在复用的情况,需要先执行 split 操作,示例:
ALTER RESOURCE POOL pool1 SPLIT INTO ('pool10','pool11') ON ('zone1','zone2');执行 delete server:
alter system delete server 'xxx:2882';确认待删除的节点在 dba_ob_servers 里不存在了
select * from dba_ob_servers where svr_ip='xxx';kill 掉待重建的节点上的 observer 进程:
kill -9 xxx导出 etc 配置文件内容:
strings observer.config.bin > observer_config.txt删除文件(注意:如果有软连接,需要保留,仅删除对应目录下的文件):
rm -rf sstable/*>rm -rf clog/*>rm -rf slog/*>rm -rf etc/observer.config.bin
rm -rf etc/observer.config.bin.history注意在正确的用户下设置环境变量并启动:
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/home/admin/oceanbase/lib启动 observer(注意调整 datafile_size 大小,其他配置见前面导出的配置文件中的值)/home/admin/oceanbase/bin/observer -r 'xx.xx.xx.xx:2882:2881;xx.xx.xx.xx:2882:2881;xx.xx.xx.xx:2882:2881' -p 2881 -P 2882 -z zone3 -c 4 -d /home/admin/oceanbase/store/obcluster -i eth0 -o "__min_full_resource_pool_memory=1073741824,memory_limit=24G,system_memory=2G,datafile_size=20G,enable_syslog_wf=False,enable_syslog_recycle=True,max_syslog_file_count=100,obconfig_url=http://xx.xx.xx.xx:8080/services?Action=ObRootServiceInfo&User_ID=alibaba&UID=ocpmaster&ObRegion=obcluster"将处理过的节点加进集群
alter system add server '172.24.255.51:2882' zone 'zone3';给对应的租户添加副本
开始其他节点的操作,步骤同上。
性能调优
问:explain 预估耗时不准,有具体过程执行耗时吗?
答:可以查看视图表 gv$sql_plan_monitor。
问:亿级别数据创建索引耗时超长怎么优化?
答:增加并行加快索引创建,设置并发SET GLOBAL OB_SQL_WORK_AREA_PERCENTAGE = 30; --- 增加SQL执行内存百分比
SET SESSION_FORCE_PARALLEL_DDL_DOP = 32; --- 设置DDL并行度
SET GLOBAL PARALLEL_SERVERS_TARGET = 64; --- 并行度增加需要设置该参数,比所有并行度和大即可,所有 DDL 的并行度加起来不超过租户 max_cpu 的上限
ALTER SYSTEM SET _TEMPORARY_FILE_IO_AREA_SIZE = '5'; --- 调大临时文件内存缓存,建议小于10
-- 如果有限流可以关闭
关闭 IO 限流:alter resource unit xxxx max_iops=10000000, min_iops=10000000; --- 1 个 Core 对应 1 万 IOPS 的值
关闭网络限流:alter system set sys_bkgd_net_percentage = 100; --- 默认60
问:大数据量插入如何提高效率?
答:可以从应用层、数据库层、工具层三个层面提高。
- 应用层: jdbc url 上开启批量参数,重写批量,ps 缓存相关参数打开。
cacheServerConfiguration=true
rewriteBatchedStatements=true
useServerPrepStmts=true
cachePrepStmts=true
当然代码也是要 addBatch,executeBatch。
- 数据库层:
- OceanBase 数据库 4.1 版本支持旁路导入,详情请参见官网 OceanBase 数据库文档 旁路导入概述。
- 4.x 版本支持并行导入,详情请参见官网 OceanBase 数据库文档 体验并行导入 & 数据压缩。
- 工具层: 使用 OBLOADER 导数工具,并按需进行调优,详情请参见官网 OceanBase 导数工具文档 性能调优。
问:OceanBase 数据库系统日志打印太大太多怎么办?
答:可参考如下命令优化。# 进入 OceanBase 数据库的日志目录
cd ~/observer/log
# 删除 wf 和日期结尾的日志
rm -f observer*.wf observer.log.2023*
# 登录系统租户(root@sys),设置系统日志参数
alter system set enable_syslog_recycle=true -- 开启日志回收
alter system set enable_syslog_wf=false --关闭 wf 日志打印
alter system set max_syslog_file_count=10 --限制日志个数,按需调整(单个日志 256M)
alter system set syslog_level ='ERROR'; --设置系统日志级别(DEBUG/TRACE/INFO/WARN/USER_ERR/ERROR),生产环境建议保持 INFO 级别,方便问题排查定位。
问:OBProxy 日志打印太大太多怎么办?
答:可使用系统租户(root@sys)或者 root@proxysys 连接 OceanBase 集群执行如下命令修改。show proxyconfig like '%log_file_percentage%';
alter proxyconfig set log_file_percentage=75;以下是 OBProxy 日志相关参数。
参数 默认值 取值范围 解释 log_file_percentage 80 [0, 100] OBProxy 日志百分比阈值。超过阈值即进行日志清理。 log_dir_size_threshold 64GB [256MB, 1T] OOBProxy 日志大小阈值。超过阈值即进行日志清理。 max_log_file_size 256MB [1MB, 1G] 单个日志文件的最大尺寸。 syslog_level INFO DEBUG, TRACE, INFO, WARN, USER_ERR, ERROR 日志级别。
问:OceanBase 数据库怎么开启慢查询记录?
答:SQL 执行时间默认情况下超过 1s 就会记录到 observer.log 日志或者在 OCP 白屏监控有记录。该配置受租户参数trace_log_slow_query_watermark控制,可通过如下命令修改配置。-- 查看参数配置
show parameters like '%trace_log_slow_query_watermark%';
-- 修改参数
alter system set trace_log_slow_query_watermark='2s';
问:如何查看某个实例(租户)下库表分区主副本的位置和大小?
答:根据不同版本有如下两种方式。
OceanBase 数据库 3.x 版本,执行如下命令。
SELECT t.tenant_id, a.tenant_name, t.table_name, d.database_name, tg.tablegroup_name , t.part_num , t2.partition_id, t2.ZONE, t2.svr_ip , round(t2.data_size/1024/1024/1024) data_size_gb
, a.primary_zone , IF(t.locality = '' OR t.locality IS NULL, a.locality, t.locality) AS locality FROM oceanbase.__all_tenant AS a
JOIN oceanbase.__all_virtual_database AS d ON ( a.tenant_id = d.tenant_id )
JOIN oceanbase.__all_virtual_table AS t ON (t.tenant_id = d.tenant_id AND t.database_id = d.database_id)
JOIN oceanbase.__all_virtual_meta_table t2 ON (t.tenant_id = t2.tenant_id AND (t.table_id=t2.table_id OR t.tablegroup_id=t2.table_id) AND t2.ROLE IN (1) )
LEFT JOIN oceanbase.__all_virtual_tablegroup AS tg ON (t.tenant_id = tg.tenant_id and t.tablegroup_id = tg.tablegroup_id)
WHERE a.tenant_id IN (1006 ) AND t.table_type IN (3)
AND d.database_name = 'T_FUND60PUB'  -- 库名
and table_name in ('BMSQL_HISTORY')  -- 表名
ORDER BY t.tenant_id, tg.tablegroup_name, d.database_name, t.table_name, t2.partition_id;
OceanBase 数据库 4.x 版本,执行如下命令。
select svr_ip,count(1) from__all_virtual_ls_meta_table where tenant_id=1002 groupby svr_ip;
问:OceanBase4.1 升级到 OB4.2 版本,NLJ 算子连接顺序变化导致查询慢问题。
答:查看以下 2 个执行计划,
- 第一个红框中的是 st 表作为驱动表和(od,cs)的 NLJ 结果进行关联, (od,cs)的结果作为物化表;
- 第二个红框的是(od,cs)的 NLJ 的结果作为驱动表和 st 表进行关联,st 表的结果作为物化表; OB4.2 执行计划:
OB4.1 执行计划:
优化思路: 既然是子查询的 NLJ 顺序变了,导致 4.2 版本的查询变慢,可以通过 hint 的方式将驱动表顺序换回来 4.1 的执行计划。子查询加上这个 hint, 确保 od,sc,st 做连接的时候 od,sc 在前,cs 在后;为了能让 od,sc 表关联走 NLJ,可以再加一个 hint 确保 od,cs 走的时候会用 NLJ 算子,所以总体上应该加的 Hint 是 /+leading(od,cs,st) use_nl(od, cs)/ 耗时从 5min 优化到 3s。 例如:SELECT ... FROM ... s, ... p WHERE 1=1 and ... AND NOT EXISTS ( SELECT /+leading(od,cs,st) use_nl(od, cs)/ 1 FROM ... st, ... od, ... cs WHERE 1=1 and ...
问:OBCDC 如何按照建表语句的顺序获取列名?
答:在 OBCDC 启动时指定配置项 enable_output_by_table_def=1(配置项自 OBCDC4.1.0.1 版本生效)。
OBD 部署问题
问题现象
使用 OBD 部署 OceanBase 数据库 V3.1.4 时提示 Warn 级别报错信息
[WARN] (x.x.x.x) clog and data use the same disk (/),安装流程可正常进行,程序正常。可能原因
生产环境下要求数据目录和安装目录配置为不同盘。小规模且短期的测试环境可以忽略,生产环境必须保证安装目录、数据目录、日志目录均是分盘目录,否则后期使用会出现非业务数据占满磁盘而出现磁盘使用率满问题。
解决方案
可执行
obd cluster edit-config xxx命令编辑配置文件,将 data_dir 和 redo_dir 设置为不同磁盘目录,保存后根据黑屏输出执行对应命令。
问题现象
使用 OBD 部署 OceanBase 集群后,通过 OBProxy 登录数据库报错
ERROR 2013 (HY000): Lost connection to MySQL server at ‘reading authorization packet’。可能原因
配置文件中 proxyro_password 和 observer_sys_password 两个配置项设置未保持一致。
解决方案
可执行
obd cluster edit-config xxx命令编辑配置文件,将配置项 proxyro_password 和 observer_sys_password 保持一致,保存后之后根据黑屏输出命令执行即可。
问题现象
obd web 部署 ob 失败,白屏显示:(2003, "Can't connect to MySQL server on 'xx.xx.xx.xx' ([Errno 113] No route to host))" observer.log 日志报错,ERROR 级别信息:Unexpected internal error happen, please checkout the internal errcode(errcode=-4009, file="ob_local_device.cpp", line_no=1405, info="Fail to fallocate block file, ")
可能原因
用户使用的 ext3 文件系统,ob 预占用使用 fallocate -l 3G /data/xx/block_file 方式申请磁盘空间,ext3 文件系统执行会报错 Operation not supported。
解决方案
数据盘和日志盘使用 ext4 或者 xfs 文件系统。
问题现象
使用 OBD 部署 OceanBase 集群后,通过 OBProxy 登录数据库报错
ERROR 2013 (HY000): Lost connection to MySQL server at ‘reading authorization packet’。可能原因
配置文件中 proxyro_password 和 observer_sys_password 两个配置项设置未保持一致。
解决方案
可执行
obd cluster edit-config xxx命令编辑配置文件,将配置项 proxyro_password 和 observer_sys_password 保持一致,保存后之后根据黑屏输出命令执行即可。
问题现象
使用 OBD V1.6.0 部署 OceanBase 数据库时报错
Open ssh connection x。可能原因
机器之间跳转使用配置文件中的 user 模块下的 ssh 连接信息,无法连接可能是未配置或配置用户信息不正确等。
解决方案
可查看 config.yaml 内关于 user 部分设置是否正确。若使用的 password 的方式,可尝试下手动使用改密码和对应用户能否登录到对应机器。
问题现象
OBD V2.0.0 中执行 obd web 命令后无法访问到白屏部署界面。
可能原因
- 防火墙问题
- 其他安全程序禁止 IP 或端口访问
- 内外网环境,部署使用内网 IP,访问需要使用外网 IP
- obd web 进程被手动杀掉
- 离线网络环境,未关闭远程仓库,导致 8680 端口未起
解决方案
您可检查是否是上述原因引起,并根据具体原因进行处理。
问题现象
执行
obd cluster deploy obce-single -c obce-single.yaml命令不成功,报错[ERROR] Failed to download [mirrors.aliyun.com/oceanbase/community/stable/el/None/aarch64///repodata/repomd.xml](http://mirrors.aliyun.com/oceanbase/community/stable/el/None/aarch64///repodata/repomd.xml) to /home/admin/.obd/mirror/remote/OceanBase-community-stable-elNone/repomd.xml后执行
obd cluster list命令查看 Cluster 状态是 configured。可能原因
OBD 默认开启远程镜像下载,无法联网环境将下载失败,需要关闭远程镜像获取,将安装包导入本地仓库,本地安装即可。
解决方案
执行
obd mirror disable remote命令禁用远程镜像仓库,并执行obd mirror clone命令将安装包复制本地仓库。
问题现象
使用 OBD 部署 OceanBase 数据库 V3.1.3 时报错 NTP 服务未同步
[ERROR] Cluster NTP is out of sync。可能原因
使用 OBD 部署时做了时差校验,当服务器之间时差超过 100ms 时,会出现 Root Server 无主情况。
解决方案
安装 NTP,进行时钟同步。
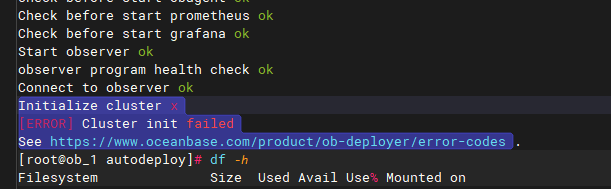
问题现象
使用 OBD 部署 OceanBase 数据库 V4.0.0 时初始化失败,报错:
[ERROR] Cluster init failed。查看 observer.log 日志出现fail to send rpc(tmp_ret=-4122字段。
可能原因
现场防火墙做了限制,导致 rpc 无法互相通信。
解决方案
关闭防火墙。
问题现象
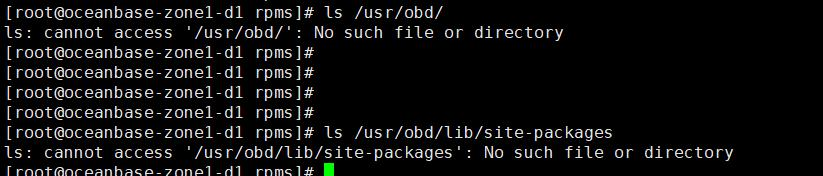
在 pymysql 模块已安装的情况下,使用 OBD V1.6.0 安装 OceanBase V4.0.0 集群的时候提示缺少 pymysql 模块:
ModuleNotFoundError:No module name 'pymysql'。
>
可能原因
示例中是启动用户不对,直接使用 root 即可,不要切换用户再 sudo,并且看报错缺少 /usr/obd/lib/site-packages 目录应该是 OBD 安装有问题,可以重新安装 OBD,现场通过创建目录拷贝方式最终也能解决。
解决方案
安装时不要使用 sudo 方式,安装使用的是当前用户进行的,创建缺少的 /usr/obd/lib/site-packages 目录,并把 python 模块拷贝进去。
问题现象
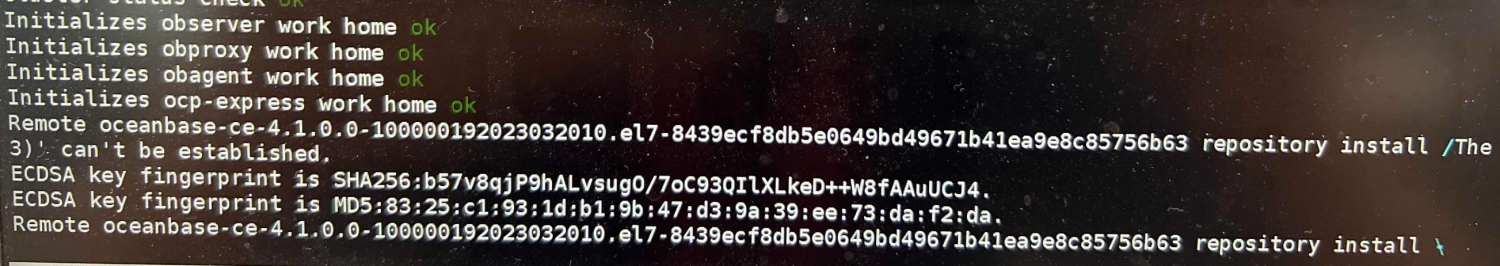
使用 OBD 部署 OceanBase 数据库时部署卡在 Remote oceanbase-ce* repository install 阶段。
可能原因
此处会涉及是拉包和传包过程,涉及基础命令,如果非公网是无法使用远程仓库的,如果磁盘可使用空间不足,也无法下载成功。
解决方案
具体需根据 OBD 日志分析,目前已知有如下可能。
- 本机缺少 rsync 命令:可执行
yum install -y rsync命令安装 rsync 命令。- sftp-server 不一致:/etc/ssh/sshd_config 配置和本机 sftp-server 路径保持一致,并重启 sshd 服务。
- 非公网环境,使用了在线安装方式:执行
obd mirror disable remote命令关闭远程仓库拉取安装包,采用离线安装。- 本地磁盘满:下载包较大,磁盘满下载将失败。
问题现象
安装过 obd2.1 版本后,重新安装 obd 低版本 2.0.1 后,obd web 执行界面报错,type object 'ConfigUtil' has no attribute 'get_random_pwd_by_rule'
可能原因
obd2.1 版本支持随机密码功能,但重新安装的 2.0.1 版本不支持,导致此类 get_random_pwd_by_rule 无法被找到。obd 不支持降级,如果需要降级,需要清理环境再安装 obd。
解决方案
- 方案 1:(适用于生产环境) 1)cd ~/.obd/
2)rm -f versiom (隐藏文件)
3)执行 obd --version,会重新生成新的 plugins 4)obd web 部署即可- 方案 2:(适用于测试环境) 1)rpm -e 卸载 obd 包
2)rm -rf ~/.obd/ 删除.obd 目录
3)重新 install.sh 安装 obd 初始化环境 4)obd web 部署即可
问题现象
OBD2.4.0 白屏部署 OB 预检查失败,报错:OBD-2007: xx.xx.xx.xx ens192 fail to ping xx.xx.xx.xx. Please check configuration
devname可能原因
- 网卡信息不正确;
- 防火墙或 selinux 未关闭或禁止 ping;
- 普通用户无 ping 权限;
解决方案
- 白屏部署时 更多配置中 需要指定 devname 参数对应的实际网卡名称。
- 关闭防火墙或 selinux,或者防火墙规则去掉禁 ping 行为。
- 部分系统普通用户无 ping 权限,root 执行:chmod u+s /usr/sbin/ping
问题现象
OBD2.3.1 部署 OBProxy 时报错:
[ERROR] failed to extract file from /root/.obd/mirror/remote/OceanBase-community-stable-el7/obproxy-ce-4.2.1.0-11.el7.x86_64.rpm可能原因
可能存在包不完整,或者包损坏等问题。
解决方案
建议去
~/.obd/repository,~/.obd/mirror/local路径删除对应安装包,重新 obd mirror clone 到本地仓库,重新部署。
OBD2.3.1 在 ky10 银河麒麟系统中部署 OB 卡在 Initialize oceanbase-ce 阶段。
可能原因
OBD2.3.1 版本暂未和 ky10 系统做兼容。
解决方案
OBD2.4.0 版本已经兼容 ky10 系统。
问题现象
OBD250 白屏部署 OB 无法选择每个节点的网卡名称。
可能原因
白屏部署暂不支持指定每台机器的网卡名称,可以黑屏部署使用配置文件指定。
解决方案
在配置文件中组件下的 servers 模块指定各个节点的网卡名。例如:
oceanbase-ce:
servers:
- name: server1
ip: xx.xx.xx.1
- name: server2
ip: xx.xx.xx.2
servere1:
zone: zone1
devname: eth0
zone: zone2
devname: eth1
问题现象
OBD2.4.0 部署报错:
[ERROR] OBD-2000: (127.0.0.1) not enough memory. (Available: 2.6G, Need: 3.0G)可能原因
这里看出是可用内存不足。 obd 检查的内存是可用的 非缓存的。
解决方案
如果服务器没其他程序,可以清理一下缓存,释放内存。
echo 3 > /proc/sys/vm/drop_caches
问题现象
OBD2.4.0 在 ubuntu 部署 OB 失败,报错:
OBD-1002: Fail to init dip(127.0.0.1) home path: /home/admin/oceanbase/ is not empty。可能原因
- 目录非空,部署需要检测安装目录是否非空。
- 用户环境变量问题。
解决方案
- 删除目录,重新部署。
- 创建用户需要指定-s /bin/bash,例如:
useradd -U admin -d /home/admin -s /bin/bash。
OBD 使用问题
问题现象
使用 OBD V1.5.0 执行
obd cluster display xx命令时报错ERROR Another app is currently holding the obd lock。可能原因
有其他进程在使用 OBD,OBD 不支持多进程同时操作。
解决方案
确认是否有未结束的 OBD 其他操作,或者有人也在调用 OBD。
问题现象
连接 OceanBase 数据库并执行命令修改完密码,使用 OBProxy 登录数据库报错
ERROR 2013 (HY000): Lost connection to MySQL server at 'reading authorization packet'。可能原因
这个报错基本是密码不一致导致,后台修改密码不会同步到 OBD 配置文件中,导致无法使用 OBD 配置中的密码登录。
解决方案
后台登录数据库还原成 OBD 配置中的密码,再通过
obd cluster edit-config命令编辑配置文件修改密码,保存后执行obd cluster reload重载集群。
问题现象
使用 OBD2.3 升级 OB4.1 到 OB4.2 时报错:
tenant tenant_cube does not meet rolling upgrade conditions(zone number greater then 2)可能原因
OBD2.3 升级 OB 时的轮转升级条件检查存在缺陷,OBD2.4.0 修复。
解决方案
升级 OBD 版本。
问题现象
OBD2.3.1 升级 OB4.x 时,在 exec upgrade_post.py 阶段失败。升级日志 upgrade_post.log 报错:
check enable_rebalance:True sync timeout可能原因
OBD2.3.1 版本升级 OB 时,需要检查 enable_rebalance 参数是开启状态,默认是开启。如果有人为关闭自动负载参数,升级会失败,后续 OBD 版本会优化。
解决方案
查看哪些租户 enable_rebalance 参数非 true:
select * from oceanbase.GV$OB_PARAMETERS where name = 'enable_rebalance';登录对应租户修改参数:ALTER SYSTEM SET enable_rebalance = true;
问题现象
OBD2.3.1 扩容 OB 节点后,ocp-express 不显示扩容的节点信息。界面报错 404:没有找到指定 obagent 类型的记录,参数:xx.xx.xx.xx,请检查后重试。
可能原因
后续版本会优化。
解决方案
需要带参数重启下 ocp-express obd cluster restart 部署名称 -c ocp-express --wp
问题现象
OBD2.3.1 进行白屏部署时,配置的用户有 sudo 和免密,预检查 ssh 相关操作还是不通过。
可能原因
执行安装 obd web 命令用户需要和免密用户不是同一个。
解决方案
使用同一个用户执行 obd web 部署。 或者界面上选择主机用户时填写密码也可以。
问题现象
OBD2.3.1 执行 deploy 命令部署报错:
[ERROR] No such install plugin for oceanbase-ce-4.2.1.1可能原因 obd 的安装有 all-in-one 和独立安装包安装 ,可以通过 command -v obd 查看一下 obd 来源
- obd 环境变量不正确,部署了多个 obd。
- obd 环境污染。
解决方案
- 如果 command -v obd 指向的 all-in-one 相关的路径 可以去用户下的.bash_profile 环境变量里面删除这个记录,继续执行。
- 如果 command -v obd 是/usr/bin/obd,可能是插件生成时候被污染了。
- 删除 obd 版本标识 rm -rf ~/.obd/version
- 执行 obd cluster list 会更新插件,有报错可以直接忽略。
- 重新执行 deloy 安装部署。
问题现象
OBD2.4.0 重启 ocp-express 服务失败,jdbc 连接 ocp-expresss 数据库时报错:
Get Location Cache Fail。客户端连接租户报错:Server is initializing。可能原因
Server is initializing 说明不是连接串租户名称不正确,而是租户还在初始化。 查看 observer.log:
allocate memory fail。导致初始化申请不到内存。解决方案
检查本机是否有其他应用程序占用内存,或者内存设置是否合理。 该案例是其他程序占用内存,导致内存不足。
问题现象
OBD2.4.0 启停集群时报错:
UnicodeEncodeError: 'latin-1' codec can't encode characters in position 77-80: ordinal not in range(256)可能原因
python 的默认编码是 latin-1,用户的环境变量可能编码有问题。
解决方案
echo 'export LANG=en_US.UTF-8' >> ~/.bashrc
echo 'export LC_CTYPE=en_US.UTF-8' >> ~/.bashrc
问题现象
OBD240 重启 OCP 失败,报错:
KeyError:'tenant_name'。可能原因
OBD240 缺陷
解决方案
OBD 启动 OCP 的命令加上 --skip-create_tenant 参数可规避,后续版本会优化。
问题现象
使用 OBD2.4.0 执行 obd mirror clone 导入文件失败,报错:
[ERROR] Running Error: 'LocalMirrorRepository' object has no attribute 'self'。
OSError: [Errno 28] No space left on device可能原因
可能是 obd 存放文件的目录快满了,导入文件太大。
解决方案
手动清理本地文件释放空间。 ~/.obd/repository/: 解压组件后存放的位置,可以随便删。 ~/.obd/mirror/local/:obd 的本地仓库,建议删除不需要使用的安装包。
OceanBase 数据库使用问题
问题现象
手动部署 OceanBase 数据库 V3.1.3,初始化 alter system bootstrap 报错
ERROR 4015 (HY000): System error。可能原因
资源不足,官方要求最小 2.5 个核心。
解决方案
调大虚拟机 CPU 核数。
问题现象
使用 OceanBase 数据库 4.x 版本新导入的数据时,做 count 查询特别慢?
可能原因
- OceanBase 数据库 4.x 版本支持自动收集统计信息,如果还未触发自动收集统计,需要手动收集统计。
- 数据量大和数据场景复杂的时候,需要手动触发合并会重整数据,加快查询效率。
- 查询如果非单纯 count 表,且租户资源不足扩展时,count 性能就会很慢,需要增大 ob_query_timeout 参数防止查询超时中断。
解决方案
- 手动收集统计信息
- 触发转储合并
- 增加 ob_query_timeout 超时参数
问题现象
OceanBase 数据库 V4.1 创建租户阶段,创建资源时报错
[1235] [0A000]: (conn=3221487627) unit MEMORY_SIZE less than __min_full_resource_pool_memory not supported。·可能原因
该报错主要是设置的 memory_limit 比 **min_full_resource_pool_memory 小导致,**min_full_resource_pool_memory 在 4.x 版本默认是 2G,3.x 版本默认是 5G。
解决方案
如果 MEMORY_SIZE 设置太小,建议是增大资源单元 unit 的 MEMORY_SIZE 参数大小,命令如下。
alter resource unit your_unit_name MEMORY_SIZE='2G';如果 MEMORY_SIZE 无法再增大了,可以降低最小资源池参数限制 __min_full_resource_pool_memory。可参考示例查看和修改该隐藏参数。
-- 查看
SELECT * FROM oceanbase.__all_virtual_sys_parameter_stat WHERE name='__min_full_resource_pool_memory';
-- 修改,示例中 2147483648 为 2G
alter system __min_full_resource_pool_memory=2147483648;
问题现象
使用 OB4.0 版本源码编译再部署时失败
报错:[ERROR] oceanbase-ce start failed
报错:ERROR [SHARE] operator() (ob_common_config.cpp:128) [20728][][T0][Y0-0000000000000000-0-0] [lt=5] Invalid config, value out of [1073741824,) (for reference only).name=min_full_resource_pool_memory, value=268435456, ret=-4147可能原因
__min_full_resource_pool_memory 该参数为 OB 隐藏参数,是允许以最小多少内存的规格创建租户的。不同版本,不同部署方式,该参数均有不同默认设置,OB 默认是 2G 大小。
解决方案
配置文件中调大**min_full_resource_pool_memory 参数的值 2147483648
alter system set min_full_resource_pool_memory= '2147483648';
隐藏参数查看方式:
SELECT \* FROM oceanbase.**all_virtual_sys_parameter_stat WHERE name='\_\_min_full_resource_pool_memory';
问题现象
OceanBase 数据库 V4.0 中使用 select outfile 语法报错权限问题。
obclient [jydb]> select * into outfile ‘/tmp/a.csv’ from a;
ERROR 1227 (42501): Access denied
可能原因
导出是到本地位置,OBProxy 代理不是本地。
解决方案
通过直连 OBServer 节点连接集群,不能通过 OBProxy 代理连接集群
问题现象
OceanBase 数据库 V4.0 中插入 1W 条数据,报错
1203 (42000): Too many sessions。可能原因
连接池需要程序设置回收。OBProxy 自身的故障或者因流量上升,OBProxy 线程用满(报错信息类似 too many sessions)。
解决方案
应用层使用未配置连接池回收时,可参考官网 OceanBase 数据库文档 ODP 线程满 增加 proxy 服务线程数 client_max_connections 参数。
OBProxy 自身故障可参考官网 Oceanbase 数据库文档 ODP 端故障。
问题现象
测试环境,内存有限,日志报 1001 租户内存不足
WARN [COMMON] try_flush_washable_mb (ob_kvcache_store.cpp:630) [52886][T1001_ReplaySrv][T1001][Y0-0000000000000000-0-0] [lt=4] can not find enough memory block to wash(ret=-4273, size_washed=0, size_need_washed=2097152)。可能原因
OceanBase 数据库 V4.0 引入了用户的 meta 租户概念,其规格配置不支持用户独立设置,具体的规则详见官网 OceanBase 数据库文档 租户的资源管理。
解决方案
可以通过调整 1001 租户的规格来自动调整对应 meta 租户的规格。
问题现象
集群中有三个 Zone,停止 Zone 操作失败
ERROR 4660 (HY000): cannot stop server or stop zone in multiple zones。可能原因
停止 Zone 时需要确保多数派副本均在线,否则操作会失败。
解决方案
环境是三个 Zone,停止一个 Zone 后,再停止一个是不允许的。
问题现象
OceanBase 数据库 V3.1.4 新建租户后,使用租户信息无法登录集群,报错
ERROR 1227 (42501): Access denied。可能原因
创建租户时默认密码为空,如果不能登录,一般是未设置白名单,导致无访问权限。
解决方案
登录系统租户(root@sys)为新创建的租户设置白名单。
ALTER TENANT xxx SET VARIABLES ob_tcp_invited_nodes='%';使用 -h127.0.0.1 登录业务租户,执行命令为本租户设置白名单。
SET GLOBAL ob_tcp_invited_nodes='%';
问题现象
字段为外键时插入数据报错
1235 - Not supported feature or function。可能原因
使用的是 sys 租户,sys 租户仅做集群管理使用,不可当做业务租户。普通租户下字段为外键时可以正常插入。
解决方案
新建普通租户进行业务使用。
问题现象
集群无法连接,observer 进程挂掉,报错
worker cnt larger than max cnt。可能原因
基本为租户 CPU 资源不足够导致。
解决方案
调大 sys_cpu_limit_trigger 参数,使其大于 16,或者更大。
问题现象
load data 导入数据报错
ERROR 1227 (42501): Access denied。可能原因
访问数据文件无权限导致。
解决方案
将导入的数据文件放到启动 OceanBase 数据库的用户权限下执行,或者执行如下命令。
set global secure_file_priv = '/tmp’;
问题现象
在 Anolis8.6 机器下,部署 OceanBase 数据库 V3.1.4 时,eth0 网卡 ping 服务器正常,但部署报错 ping 失败:eth0 fail to ping xxx.xxx.xxx.xxx. Please check configuration
devname。可能原因
兼容性问题,后续版本修复。
解决方案
执行
chmod u+s /usr/sbin/ping命令。
问题现象
升级 OceanBase 数据库 V3.1.0 至 V3.1.4 失败,报错:
fail to get upgrade graph: ‘NoneType’ object has no attribute 'version'。可能原因
OceanBase 数据库 V3.1.0 不支持本地升级,只能做数据迁移这种逻辑升级。
解决方案
重新搭建一套 OceanBase 数据库 V3.1.4 环境,通过 OMS 进行数据迁移。
问题现象
OceanBase 数据库 V3.1.4 中使用业务租户修改 lower_case_table_names 参数报错
Variable 'lower_case_table_names'is a read only variable。可能原因
MySQL 的只读变量在 MySQL 里即使是 root 也不能修改,需要拥有主机访问权限的人在外部修改配置文件后重启实例生效。OceanBase 数据库的 MySQL 租户是逻辑实例,没有独立进程,不存在重启操作。所以需使用有 sys 租户权限的超级管理员去修改租户的全局参数变量。
解决方案
使用系统租户 root@sys 操作。
问题现象
OceanBase 数据库 V3.1.4 中一次性导入大批数据报错租户内存不足
ERROR: No memory or reach tenant memory limit。可能原因
有如下两种原因。
- 系统租户本身作为系统管理者,资源有限,不适合业务使用。
- 磁盘写满,无法触发转储合并,租户内存会写满。
解决方案
根据不同原因有如下几种解决方案。
- 不能使用系统租户 root@sys 当业务租户使用。
- datafile_size 不能太小,防止租户的磁盘被写满。
- 通过参数调优,可以降低内存写满风险
- 租户内存阈值 memstore_limit_percentage 调大。
- 触发版本冻结的阈值 freeze_trigger_percentage 调小。
- MemStore 写入限速阈值 writing_throttling_trigger_percentage 设置 70。
问题现象
OBClient(2.x 版本)通过 OBProxy 连接 OceanBase 数据库(V4.0.0)proxysys 租户时报错
ERROR 2027 (HY000): received malformed packet,但是使用 MySQL 客户端连接正常。可能原因
OBClient 2.x 版本使用 root@proxysys 用户连接到 OceanBase 数据库之后,会发送 SQL 语句查询 version,OBProxy 会直接回复 EOF 包,这个包在 OBClient 1.x 版本时是会被忽略,在 OBClient 2.x 版本时会解析异常。
解决方案
可暂时使用 MySQL 客户端,该问题下个迭代修复。
问题现象
OceanBase 数据库 V4.0.0 中导入表的时候总是报
ERROR 4263 (HY000): Minor freeze not allowed now,且无法 truncate 表数据。查看日志显示如下。WARN [STORAGE.BLKMGR] alloc_block (ob_block_manager.cpp:305) [9021][T1_MINI_MERGE][T1][YB42C0A81FCA-0005EC7D0FFFD8D6-0-0] [lt=22] Failed to alloc block from io device(ret=-4184)
WARN [STORAGE] alloc_block (ob_macro_block_writer.cpp:1132) [9021][T1_MINI_MERGE][T1][YB42C0A81FCA-0005EC7D0FFFD8D6-0-0] [lt=4] Fail to pre-alloc block for new macro block(ret=-4184, current_index=0, current_macro_seq=0)可能原因
Minor freeze not allowed now 指的是无法进行转储,原因一般有:
- 租户分配磁盘空间占满,内存的数据无法转储。
- 使用了系统租户当业务租户使用,系统租户资源较少,转储性能跟不上。
- 使用了业务租户,但该租户的内存资源较少,转储性能跟不上。
解决方案
增大对应租户的磁盘资源,命令如下。
alter resource unit xxx datafile_size='xxG'
问题现象
部署 OceanBase 数据库 V4.0.0 时报错
[ERROR] OBD-1006: Failed to connect to oceanbase-ce。
查看 observer.log 日志显示ERROR [CLOG] resize (ob_server_log_block_mgr.cpp:183) [2790][][T0][Y0-0000000000000000-0-0] [lt=5] The size of reserved disp space need greater than 1GB!!!(ret=-4007。可能原因
log_disk_size 用于设置 Redo 日志磁盘的大小,不能小于 1G 的限制,默认为分配内存的 3~4 倍。
解决方案
配置文件中调大 log_disk_size 参数。
问题现象
单机 demo 部署 OceanBase 数据库 V4.0.0 ,通过 OBProxy 连接数据库时经常出现断连现象,但是通过 OBServer 直连却没有问题。报错信息如下。
ERROR 2013 (HY000): Lost connection to MySQL server during query
ERROR 2006 (HY000): MySQL server has gone away
No connection. Trying to reconnect…
可能原因
现在 demo 模式中 OBProxy 给的内存比较少(200M),可能有触发内存超限重启的问题,后续版本会优化。
解决方案
执行如下命令调大 proxy_mem_limited 参数为 500M 或 1G。
alter proxyconfig set proxy_mem_limited ='1G';
问题现象
通过 OBD 单机部署 OceanBase 数据库 V3.1.4 后启动失败,通过 OBProxy 连接报错
ERROR 2013 (HY000): Lost connection to MySQL server at 'reading authorization packet', system error: 0,日志报错如下。ERROR [SERVER.OMT] alloc (ob_worker_pool.cpp:93) [24864][454][Y0-0000000000000000] [lt=22] [dc=0] worker cnt larger than max cnt(worker_cnt_=256, max_cnt_=256)可能原因
OceanBase 数据库最低以 cpu_count 16 启动,如果修改过该参数可能导致无法启动。
解决方案
执行
obd cluster edit-config编辑配置文件,调大 cpu_count 配置项,保存修改后根据黑屏输出执行对应命令重启即可。
问题现象
导入数据到 OceanBase 数据库 V4.0.0 期间出现切主报错信息
ERROR [ELECT] leader_revoke (ob_election.cpp:2151) [42767][1849][Y0-0000000000000000] [lt=13] [dc=0] leader_revoke, please attention!(revoke reason=“clog sliding_window timeout”可能原因
Leader 同步 Clog 超时导致切主。
解决方案
可以尝试调小客户端压力,或者调大 _ob_clog_timeout_to_force_switch_leader,这是日志同步超时配置项,可以通过 oceanbase.__all_sys_parameter 表查看,默认值为 10 秒,可适当调大,影响是 leader 异常时,相应的 RTO 也会变长。
问题现象
OceanBase 数据库 V3.1.0 申请不到内存,合并超时,转储卡住。日志报错:
Fail to alloc data block, (ret=-9202)。可能原因
有如下两种可能原因。
- 可能是磁盘被占满,可以通过
df -h查看。- 可能是设置的 datafile 使用完了,可以通过查询 __all_virtual_disk_stat 查看 OceanBase 数据库整体磁盘占用信息。
解决方案
可通过扩容解决,或者增大 datafile_size / datafile_disk_percentage 配置。
问题现象
OceanBase 数据库 V3.1.4 执行合并报错:
ERROR 4179 (HY000): Operation not allowed now,rootserver 日志报错:enable_major_freeze is off, refuse to to major_freeze。可能原因
enable_major_freeze 默认是开启的,测试环境修改了参数,导致无法手动触发合并。
解决方案
执行
alter system set enable_major_freeze='true';打开合并参数。
问题现象
OceanBase 数据库 V4.1 中 sys 租户设置数据备份路径报错。
- 执行 SQL:
ALTER SYSTEM SET data_backup_dest=‘file:///data/bak’;。- 报错:
ERROR 1235 (0A000): Not supported feature or function。- 日志信息:
WARN log_user_error_inner (ob_table_modify_op.cpp:1042) [7800][EvtHisUpdTask][T1][YB42ACAC1F54-0005F645ABA8855E-0-0] [lt=18] Data too long for column ‘value2’ at row 1。可能原因
OceanBase 数据库 4.x 版本为租户级别备份,且 sys 租户不能为其自身备份,sys 租户登录操作的话,需要指定备份的租户,其中 log_archieve_dest/data_backup_dest 也只能为业务租户备份设置。
解决方案
设置时指定为业务租户:
ALTER SYSTEM SET data_backup_dest=‘file:///data/bak/’ TEANT = $your_tenant_name;。
问题现象
OceanBase 数据库 V4.1 后台设置日志归档备份路径报错。
- 执行 SQL:
ALTERSYSTEMSET LOG_ARCHIVE_DEST='LOCATION=file:///data/bak' TENANT = fund;。- 报错:
ERROR 9081 (HY000): the content of the format file at the destination does notmatch。可能原因
OceanBase 数据库 4.x 版本,日志备份目录 log_archive_dest 和数据目录 data_backup_dest 不能在同级目录下。因为每一个路径下都有一个 format 校验文件,该文件记录该路径的一些相关属性,设计上不允许备份目录相同。
解决方案
将日志备份目录和数据目录设置到不同目录层级下,例如:
ALTER SYSTEM SET data_backup_dest='file:///data/bak/logdir';。
问题现象
OCP 备份和手动发起 ALTER SYSTEM ARCHIVELOG 命令报错
ERROR 1235 (0A000): start log archive backup when not STOP is not supported可能原因
日志备份进程仍在,不能重复执行备份。
解决方案
如果是初次全量备份,可以关停备份并清理备份任务和进程,重新发起。
--关闭日志备份
 ALTER SYSTEM NOARCHIVELOG;
--强制取消所有备份任务(备份目录会重置)
ALTER SYSTEM CANCEL ALL BACKUP FORCE;
--查看备份路径
SHOW PARAMETERS LIKE 'backup_dest'
--修改备份目录
ALTER SYSTEM SET backup_dest='file:///data/obbackup';
--启动日志备份
ALTER SYSTEM ARCHIVELOG
问题现象
OceanBase 数据库 V3.1.4 启动日志备份后,很快就显示断流 interrupted。查看日志显示
log archive status is interrupted, need manual process(sys_info={status:{tenant_id:1, copy_id:0, start_ts:1671070878595931, checkpoint_ts:1671070878595931, status:5, incarnation:1, round:3, status_str:“INTERRUPTED”, is_mark_deleted:false, is_mount_file_created:true, compatible:1, backup_piece_id:0, start_piece_id:0}, backup_dest:“file:///home/nfs_server/backup”})。可能原因
有如下两种可能原因。
- nfs 客户端配置错误。
- nfs 服务器目录权限不够。
解决方案
根据以上原因,有如下两种解决办法。
- OceanBase 数据库为 NFS 客户端,需要所有 OBServer 节点本地创建备份目录挂载到服务端的 NFS 地址。
- 将 NFS 服务器上 backup 目录修改属组 nfsnobody:nfsnobody,或者 777 权限。
问题现象
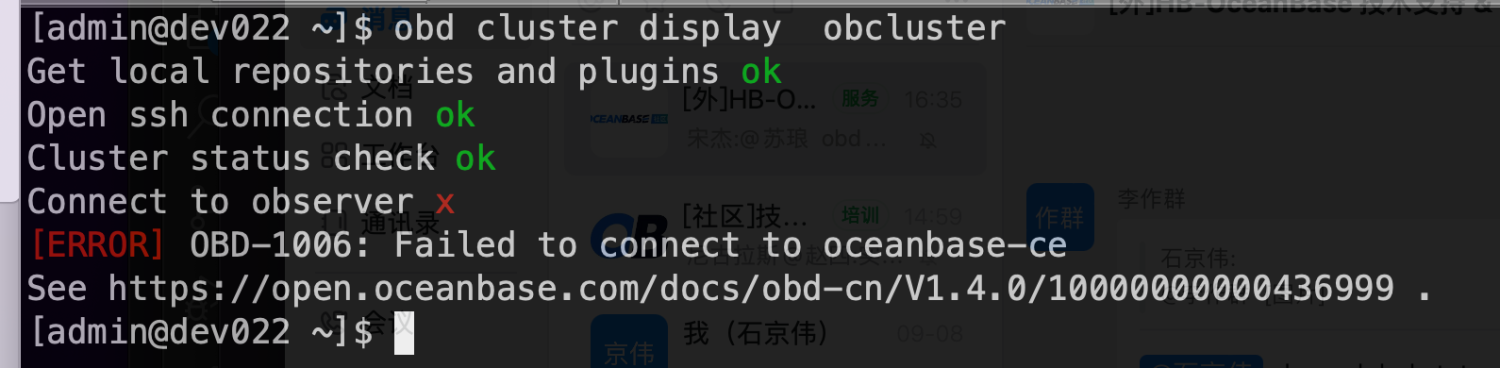
用 OBD 管理集群时报错
OBD-1006: Failed to connect to oceanbase-ce,实际集群状态正常,OBD 日志报错密码不正确Access denied for user。可能原因
用户未通过 OBD 方式修改密码,而是直接登录数据库修改,但 OBD 配置文件不会同步修改,导致密码配置不一致,且当前情况下因为密码已经不一致,无法再通过 OBD 修改密码。
解决方案
登录数据库设置系统租户密码和 OBD 配置文件中
root_password配置项保持一致,此时可以成功通过 OBD 管理集群。若仍想修改密码,可执行obd cluster edit-config命令编辑配置文件,修改root_password配置项为想要修改的密码。
问题现象
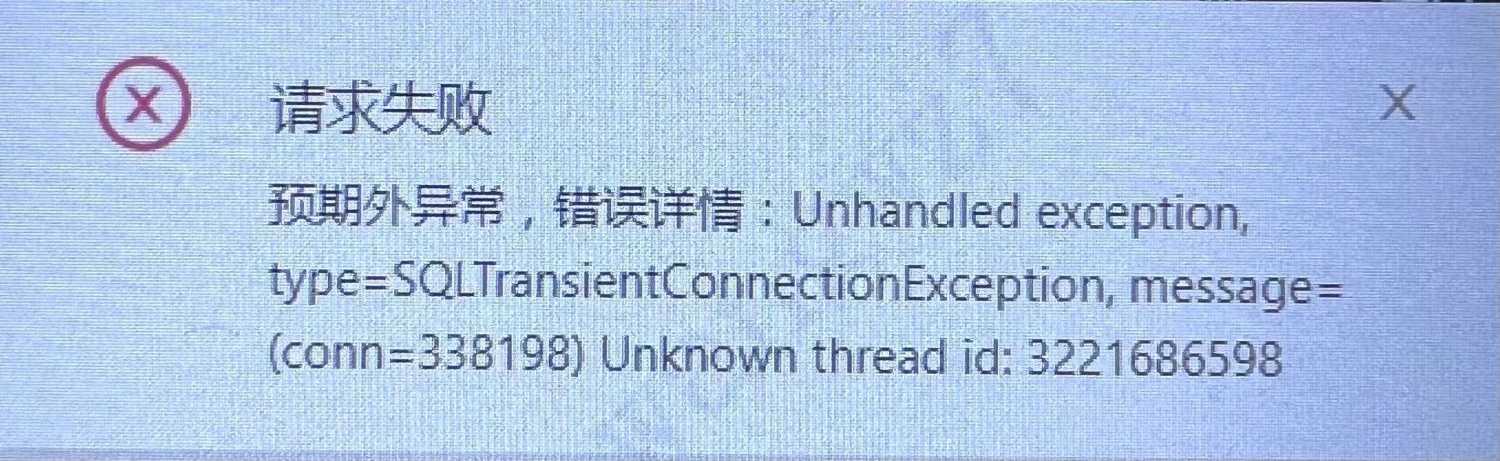
ODC 上 执行 SQL 报错
Unkown thread id。可能原因
unknow thread id 是因为在 JDBC 代码执行 SQL 时,设置了 ob_query_timeout,超时后驱动就会执行
kill query connectionId命令将超时执行的 SQL 取消掉。但是这个命令在存在多个 OBProxy 时,可能会发给其他的 OBProxy,就会报错 unknow thread id。解决方案
增大超时参数 ob_query_timeout,同时也建议增大事务参数 ob_trx_timeout、ob_trx_idle_timeout。
问题现象
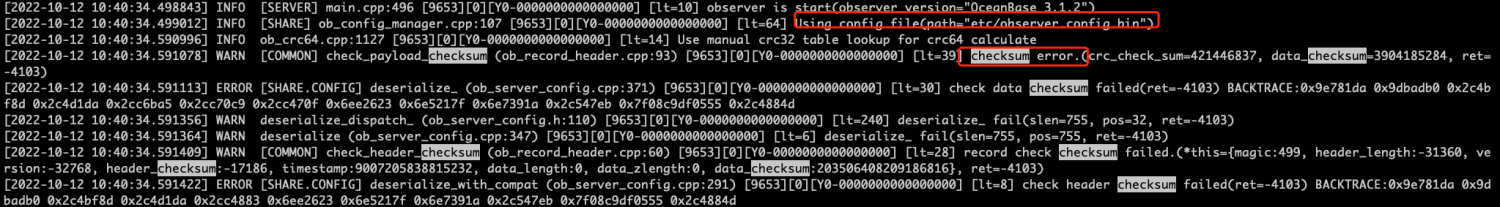
OceanBase 数据库 V3.1.4 动修改 observer.config.bin 文件后启动失败,报错
check data checksum failed(ret=-4103)。
可能原因
首先不支持直接手动修改该二进制文件,该文件配置参数是通过 alter system 方式持久化此处的,可以通过
./bin/observer -o 参数=参数值的方式启动,启动成功后也会持久化到该配置,当然。解决方案
etc2 和 etc3 下有备份文件,该配置文件加上 history 一共有六份,可以 cp etc2/observer.conf.bin etc/observer.config.bin 恢复配置。
find /home/admin/oceanbase  |grep  "observer.conf"
/home/admin/oceanbase/etc3/observer.conf.bin
/home/admin/oceanbase/etc3/observer.conf.bin.history
/home/admin/oceanbase/etc2/observer.conf.bin
/home/admin/oceanbase/etc2/observer.conf.bin.history
/home/admin/oceanbase/etc/observer.config.bin
/home/admin/oceanbase/etc/observer.config.bin.history
问题现象
springboot 项目使用 OceanBase 数据库 V4.0.0,数据库中字段是 datetime 格式,用 bean 接收 SQL 查询的结果,bean 中使用 string 来接收,出现
2022-12-08 12:23:56.0,预期结果是2022-12-08 12:23:56。解决方案
对于 OceanBase 数据库的 datatime 格式,建议使用 Date 的数据类型接收。如果想要用 String 接收 OceanBase 数据库的时间类型,建议尝试将数据库改为 timestamp 格式。
问题现象
OceanBase 数据库 V4.0.0 在给日期类型 datetime 的字段按年分区时报错
ERROR 1564:This partition function is not allowed。可能原因
原生 MySQL 也如此表现,报错符合预期,Hash 分区键的表达式必须返回 INT 类型,left 截取方式返回的是字符串类型。
解决方案
可以按如下函数语法获取年/月。
- PARTITION BY RANGE( YEAR(dt) )
- SUBPARTITION BY HASH( MONTH(dt) )

问题现象
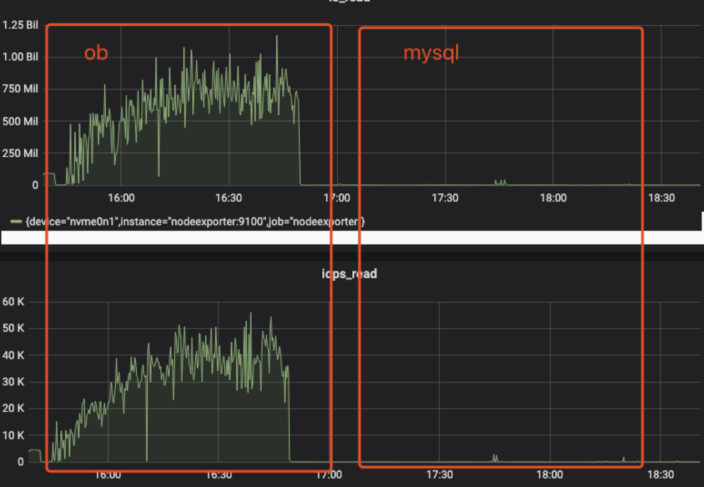
OceanBase 数据库 V4.0.0 在 write only 场景时,磁盘读在一个较高的频率,纯写场景为什么会有这个高的读操作?
可能原因
OceanBase 数据库的存储整体是一个 LSM 架构,从上到下是 MemTable,Minor SSTable,Major SSTable,数据从 MemTable 到 SSTable 会写盘,从 Minor 到 Minor/Major 会读盘 + 写盘,Minor SSTable 累积一定数量后也会触发合并,合并需要重排列,需要读+写磁盘。
解决方案
符合预期,无需解决。
问题现象
500 租户内存超限,500 租户内存使用过多会导致机器内存资源耗尽,OBServer 内的租户会因为内存不足而无法正常工作。
可能原因
先看下 500 租户内存占用模块大小信息:
select * from __all_virtual_memory_info where tenant_id='500' order by hold desc limit 10;
开启内存泄露监控
alter system set leak_mod_to_check= '$mod_name';
查询有明显的增长时停止
select * from __all_virtual_mem_leak_checker_info order by alloc_count;然后及时关闭内存泄露监控
alter system set leak_mod_to_check= '';
查看 back_trace
SELECT * FROM __all_virtual_malloc_sample_info WHERE mod_name='IlogMemstoCurso' ORDER BY alloc_bytes DESC limit 10;
根据 addr2line 解析对应的 back_trace
addr2line -pCfe bin/observer 0x9a98f75 0x984dddc 0x9847352 0x22e173d 0x22e2886 0x22e3025 0x7c5931e 0x7c58854 0x7c58469 0x7c0b548 0x7b6c3aa 0x7b2d630 0x7b2bea9 0x7f91517 0x7f91ddc 0x7f92c71 0x84b8115 0x7c94650 0x7c9e717 0x7c9d391 0x3432bfa 0x3436070 0x340b9af 0x2cabf02 0x9820da5 0x981f792 0x981c24f解决方案
如果没有 addr2line 命令,yum install -y binutils 进行安装如果无法分析堆栈,可以开源问答区发帖,社区值班开发会协助分析。 应急处理:重启告警对应节点 observer 服务,但可能无法分析问题原因。
问题现象
OB4.x 版本建表时提示 Caused by: java.sql.SQLException: Row size too large
可能原因
OB 限制单表行长度 1.5M,指的是所有字段类型长度加在一起不超过 1.5M。
解决方案
使用其他字符集或使用其他数据类型,将大字段或长字段类型适当调整为其他可替代类型或长度。
问题现象
oceanbase4.1 版本扩容节点后性能未提升?
可能原因
可以查看表数据分布情况,因为 OB4.1 不支持扩容前的数据均衡,即历史数据无法负载到所有节点,4.2 版本开始支持。
select svr_ip,count(*) from dba_ob_table_locations where database_name='xx' group by svr_ip;解决方案
升级到 OB4.2 版本或最新版本,或者重新部署最新版本集群。
问题现象
OCP 告警 OceanBase 归档日志备份延迟,
tailf observer.log |grep "get ls arcchive progress failed"或者"failed to stat file"所有租户的 1 号日志流都报错 ret=-4023。可能原因
这种所有租户日志流失败基本可以定位是全局问题,涉及备份的全局场景要么是集群故障,或者是 nfs 服务有问题。
解决方案
排查 NFS 挂载信息。例如文件目录访问权限、用户组权限、NFS 连通性等。
该案例排查比较特殊,observer 的进程用户 admin 的 uid 被修改了,导致部分文件和资源无法访问。
该案例恢复方式:usermod -u 1001 admin#1001 根据实际的 uid 填写。
问题现象
OB4.2 版本创建表时报错:
ERROR 1499 (HY000): Too many partitions (including subpartitions) were defined可能原因
- 内存不足以支持更多表;
- 创建的单分区表超过 8192 个分区;
- 如果是开启了回收站,大量废弃的表未即使清理也会占用分区数;
解决方案
- OB4.x 版本,1G 内存约支持 2 万 tablet,如果内存太小,可以尝试扩大租户内存来支撑更多表分区。
- OB 单分区表限制,单分区表不能超过 8192 个子分区。
- 需要清理回收站。
问题现象
OB3.1.4 版本的 sql 中条件 in 超过 1000 个参数后执行报错:
Size overflow。可能原因
大 in 场景,该版本存在优化问题。
解决方案
- 减少 in 的个数
- 或者调整参数 stack_size 为 15M,同时调大 system_memory=system_memory+OBserver 线程数*stack_size。适用于 OB3.x 版本环境。
问题现象
OB3.1.5 版本在执行 alter system restore 做数据恢复时报错:
ERROR 9011(HY000): cannot find backup file。可能原因
该报错基本是恢复 sql 语句 at 和 with 中的参数和实际配置不符合导致。
解决方案
该案例是 with 参数中的集群名称填写错误导致。 集群名称查看:
show parameters like '%cluster%';返回的 value 字段对应。
问题现象
OB4.1 版本连接业务租户长时间等待,无法登录进去。
observer.log 报错:
WDIAG [COMMON] wait (ob_io_define.cpp:859) [14132][][T500][Y0-0000000000000000-0-0] [lt=21][errcode=-4224] IO error, (ret=-4224
WDIAG [COMMON] read (ob_io_manager.cpp:159) [14132][][T500][Y0-0000000000000000-0-0] [lt=46][errcode=-4224] io handle wait failed(ret=-4224可能原因
通过日志报错解析出现了磁盘 IO 等待问题,如果磁盘 IO 读写性能变慢或者读写卡顿会出现该问题现象。
- 磁盘硬件可能有故障;
- 磁盘 IO 可能被占满,比如:使用性能较低的机械盘,或者数据和日志同盘,或者业务不合理占用大量磁盘 IO 等。
解决方案
- 该案例是磁盘故障,压缩和解压文件时会出现长时间卡住无法结束,需要替换磁盘。 磁盘故障可以使用 smart 命令检查或者查看/var/log/messages 系统日志。
- 磁盘 IO 可以通过
iostat -x 1命令检查磁盘 IO 读写或者 IO 等待。如果是生产环境,存在机械盘或者同盘问题,强烈建议更换 SSD 磁盘且数据和日志分盘部署。
问题现象
OB4.1 版本调整租户 locality 时,提示:
operation not allowed now
observer.log 报错:WARN [RS] process_ (ob_rs_rpc_processor.h:117) [5653][DDLQueueTh0][T0][YB420A581A34-0005F940407C5D80-0-0] [lt=1] ddl operation not allow, can not process this request(ret=-4179, pcode=528)可能原因
operation not allowed now比较宽泛,需要通过报错日志查看内核代码(obrs_rpc_processor.h:117),对应版本和行号代码(!GCONF.enable_ddl && !is_allow_when_disable_ddl(pcode, ddl_arg) ,可以判断和 enable_ddl 参数相关。解决方案
该案例 enable_ddl 被修改为 false,将数据库系统参数 enable_ddl 设置为 true 即可。该参数被修改大概率是升级 OB 失败导致,建议用户将 OB 升级完成,不建议跳过任务。
问题现象
OB3.1.4 节点宕机后重新上线后 unit 不自动负载了,observer.log 报错有关键字:
ld tenant can't be dropped。可能原因
有 unit 的 GC 无法完成。当一个 zone 内有节点汇报给 RS 的资源占用与实际不符时(包括未 GC 的 unit),则此时该 zone 不会执行负载均衡,unit 也无法 GC。后续 OB3.1.5 版本会优化修复。
解决方案
需要重启 observer.log 打印
old tenant can't be dropped关键字的节点 ob 服务。
问题现象
OB4.2.0 版本主备租户场景,执行租户升级
ALTER SYSTEM RUN UPGRADE JOB "UPGRADE_ALL"版本未统一,重复执行报错:[4179][HY000]: Operation not allowed now。可能原因
主备租户集群需要保持版本一致,纯主集群和纯备集群升级顺序:升级备集群,再升级主集群,两边的租户版本会保持一致,无需再执行升级租户命令。
解决方案
主租户集群也升级至同版本即可。
问题现象
OB4.2.1 初始化失败,observer.log 报错:
Unexpected internal error happen, please checkout the internal errcode(errcode=-4013, file="protected_stack_allocator.cpp", line_no=85, info="alloc failed")可能原因
启动环境中 stack_size 值被修改,默认参数 512k,导致申请线程栈失败,该参数不建议用户调整。
解决方案
手动指定参数启动
./bin/observer -o "stack_size=512k"
问题现象
OB4.1.1 版本,磁盘未占满,但磁盘 IO 繁忙,OCP 告警:
Server out of disk space(msg="disk is almost full", ret=-4184。observer.log 有相关报错:fail to check space full(ret=-4184)
fail to write tmp block(ret=-4184)可能原因
OB420 版本修复磁盘负载过高时,临时文件 I/O 异常可能导致报错 4184 磁盘满问题。
解决方案
升级 OB420 版本或以上版本即可。
问题现象
obproxy 访问 OB4.2.1 时,提示
ERROR 4669 (HY000):cluster not exists。可能原因
show parameters like '%cluster%';value 字段对应的是正确的集群名称;- 如果集群名称正确的可能是配置了 obproxy_config_server_url 参数,该参数优先级高于 rootservice_list。
解决方案
- 使用 value 字段对应的集群名称即可;
- 如果配置了 obproxy_config_server_url 且和实际集群名称不一致,可以把参数置空,
alter proxyconfig set obproxy_config_server_url='';
问题现象
OB4.2.1 租户合并失败,observer.log 报错:
failed to merge partition(ret=-4184)可能原因
可能是剩余磁盘空间不足,用户业务数据占用接近阀值 90%时,导致合并刷宏块时,磁盘 free block 容量不足,无法触发合并。
解决方案
扩数据磁盘容量。
问题现象
OB4.2.1 做 sysbench 压测报错 lost connection。 屏幕打印:
SQL error,errno = 2013,state = 'HY000' : Lost connection to server during query
obproxy.log 报错:obproxy's memory is out of limit,will be going to commit suicide可能原因
proxy_mem_limited 太小,压测期间导致 obproxy 内存太小出现断连问题。
解决方案
增大 obproxy 内存,proxy_mem_limited 参数,默认值为 2G。
问题现象
OB4.2.1 执行 sql 报错磁盘故障,
ERROR 4392 (HY000) : disk is hung。可能原因
磁盘性能不足会导致读写占用大量 IO,出现等待,超出 data_storage_warning_tolerance_time,log_storage_warning_tolerance_time 默认时间,会判定为磁盘故障。
解决方案
- 更换 SSD 或者高性能磁盘。
- 如果确定磁盘性能正常,可以适当调大 log_storage_warning_tolerance_time 或者 data_storage_warning_tolerance_time 参数,默认 5s。
问题现象
OB4.2.1 版本表结构存在生成列,load data 导入数据报错
ERROR 1048 (23000): Column cannot be null。可能原因
报错指的是生成列不能为空,当存在有生成列的情况下,需要指定非生成列字段名导入。
解决方案
load data infile '$path' into table $tableName fields terminated by ',' (field1,field2,field3,field4);插入的字段不指定生成列字段。
问题现象
OB4.2.1 的收站中过期数据未自动清理,设置了很小的保留时间也未触发清理。
可能原因
控制回收站清理的除了过期时间参数 recyclebin_object_expire_time,还有回收频率的隐藏参数_recyclebin_object_purge_frequency,默认 10 分钟。
解决方案
等待 10 分钟或者设置隐藏参数的值
SELECT * FROM oceanbase.__all_virtual_sys_parameter_stat WHERE name='_recyclebin_object_purge_frequency';
问题现象
OB4.1.0 测试回收站手动清理时报错:
4179 Operation not allowed now。可能原因
在 sys 租户下进行回收站操作了,sys 租户作为管理租户存在一些操作和功能限制。
解决方案
回收站操作在普通租户中操作,sys 租户不建议使用。
问题现象
做了磁盘阵列 reid0 的 OB4.1.0 的 observer.log 有大量报错:
Data checksum error(msg="log checksum error", ret=-4103可能原因
已经和 intel 官方确认为磁盘阵列卡中的 bug。使用 write through, 数据直接写到磁盘, 读取时也会从磁盘上读取, 解决了 cache 脏数据的问题。
解决方案
磁盘阵列 cache 设置为 write through。
问题现象
docker 环境安装 OB,只能使用 localhost 进行链接,使用 IP 地址连接不上,报错:
2013 - Lost connection to server at 'handshake:reading initial communication packet',system error:0。可能原因
宿主机上 OB 的 2881 和 2882 端口被占用。
解决方案
杀掉占用端口的进程。
问题现象
使用 mybatis-plus-boot-starter 3.4.2 版本,批量删除和插入数据到 OB4.2,出现删除和插入不完整现象。
可能原因
mybatis-plus-boot-starter 3.4.2 版本,取出来的数据 id 没有顺序,导致后面的逻辑错误。
解决方案
mybatis-plus-boot-starter 3.5.3 版本修复。
问题现象
使用 mybatis-plus-boot-starter 3.4.2 版本,做关联查询时结果集是无序的。
可能原因
mybatis-plus-boot-starter 3.4.2 版本,取出来的数据 id 没有顺序,导致后面的逻辑错误。
解决方案
mybatis-plus-boot-starter 3.5.3 版本修复。
问题现象
OB4.1.0 设置了 max_syslog_file_count 参数后,系统日志未自动删除,重启 OB 也未清理。
可能原因
enable_syslog_recycle 自动回收参数未打开。
解决方案
打开该参数,
ALTER SYSTEM SET enable_syslog_recycle='True';
问题现象
TPCC 测试 OB4.2 版本时,terminals 设置大测试会失败。obproxy.log 报错:
failed,-4124和failed to accept con(ret=-10024)可能原因
accept 系统调用时报错了:EMFILE,打开的 file 太多了,猜测是系统 fd 不够用了,需要检查 ulimit -a 打开文件数配置。
解决方案
设置 OB 和 OBProxy 节点的最大文件数 open files,建议 OB 的部署用户文件数设置为 655350。
问题现象
miniOB 在 mac M1 芯片编译报错:
CMake Error at /usr/local/lib/cmake/libevent/LibeventConfig.cmark:172 (message):Can not find any libraries for libevent。可能原因
使用 brew 安装的 libevent 时没有生成 cmake 文件。
解决方案
- 正确的安装 libevent 方式如下:
git clone https://github.com/libevent/libevent.gitmkdir build && cd buildcmake ..makemake installmake install 后出现以下内容即为成功。
-- Installing: /usr/local/lib/cmake/libevent/LibeventConfig.cmake
-- Installing: /usr/local/lib/cmake/libevent/ LibeventConfigVersion.cmake
-- Installing: /usr/local/lib/cmake/libevent/LibeventTargets-static.cmake
-- Installing: /usr/local/lib/cmake/libevent/LibeventTargets-static-release.cmake
-- Installing: /usr/local/lib/cmake/libevent/LibeventTargets-shared.cmake
-- Installing: /usr/local/lib/cmake/libevent/LibeventTargets-shared-release.cmake
问题现象
JDBC 批量(一次一万条)插入 OB4.1 版本时报错:
com.oceanbase.jdbc.internal.util.exceptions.MaxAllowedPacketException:query size (4194308) is >= to max_allowed_packet (4194304)设置 max_allowed_packet 参数后,报错:java.sql.SQLNonTransientConnectionException: (conn=2388917) packet sequence mismatch, expected obSeqNo=3, but received obSeqNo=1 at com.oceanbase.jdbc.internal.util.exceptions.ExceptionFactory.createException(ExceptionFactory.java:122) ~[oceanbase-client-2.4.3.jar:?]可能原因
- max_allowed_packet 报错比较明显,需要调整 max_allowed_packet 参数,可以按 5-10 倍增加。
- 和 OB 的驱动有关系,可以调整 jdbc 参数观察下。
解决方案
SET GLOBAL max_allowed_packet= '';-- 根据情况定义,单位为 byte。- 两种方法:
- jdbc 链接增加 useOceanBaseProtocolV20=false -- 不使用 ob2.0 协议。
- jdbc 链接增加 useServerPrepStmts=true -- 使用服务器 prepare。
问题现象
OB4.2.1 版本 1-1 架构扩容成 2-2 后,租户已经设置 unit_num=2,但新插入的数据不会自动负载到新节点。
可能原因
需要扩容节点版本和原集群版本保持一致。
解决方案
扩容节点和原集群版本需要一样,可以整体升级或者缩容重新扩容相同版本。
问题现象
OB4.2.1 使用腾讯 COS 进行做备份时,归档备份报错:
ERROR 9060 (HY000): COS error。grep "list_objects.*ob_cos_wrapper.cpp" rootservice.log和 observer.log: status->error_code: InvalidRegionName status->error_msg: The specified region is invalid or unreachable.可能原因
COS 使用姿势的问题,可能 host 设置错了或者不可访问。
解决方案
host=obbackup-xxxxxx.cos.xxxx.com 改为 host=cos.xxxx.com 路径格式不正确。
问题现象
obcdc 连接 OB4.2 时报时区不正确:
fail to get get_tz_info_by_name(tz_name=Zulu, ret=-4018)。 observer.log 报错:
Unexpected internal error happen, please checkout the internal errcode(errcode=-5192, file="ob_log_timezone_info_getter.cpp", line_no=65, info="tz_info_wrap set_time_zone failed")。[errcode=-5192] tz_info_wrap set_time_zone failed(ret=-5192, ret="OB_ERR_UNKNOWN_TIME_ZONE", timezone_str=Zulu。可能原因
obcdc 配置的时区是 Zulu
config.add("timezone","Zulu")。解决方案
timezone 支持
'+08:00'的 offset 形式和 Asia/Shanghai 的地域形式取值,但不支持直接配置 Zulu 方式,可以改写成config.add("timezone","+00:00:00")。
问题现象
OB4.x 迁移完后数据存储空间出现膨胀,比实际数据占用空间要大很多。
可能原因
OceanBase 存储出现空洞的原因:OceanBase 的数据文件 SSTABLE 按照主键顺序进行存储,如果业务数据插入比较离散,期间有合并时,2M 宏块出现分裂会导致数据空洞率提升,进而导致存储空间大于数据数据空间, 这种现象多见于业务主键非递增插入的场景。
解决方案
对空洞较大的表强制执行全量合并。 强制执行全量合并,不执行渐进合并。 对于新建表:
set default_progressive_merge_num=1。 对于现存表:ALTER TABLE $table SET progressive_merge_num=1;这样把需要的表设置上,再进行合并。 注意:全量合并会消耗大量资源,需要设置完之后再设置回 0。
问题现象
OB4.2 基于日志归档的主备租户同步,延迟 2 分钟。
可能原因
记录租户数据变化的是这个/home/admin/back/piece_d1001r1p1/logstream_1001/log/下的 .obarc 文件,并非是只有业务数据的变化。日志归档备份默认 120s 提交一次,控制参数 archive_lag_target。
解决方案
可以调整 archive_lag_target 参数增加同步频率。
问题现象
服务器重启后,OB4.x 启动失败。 observer.log 报错:
EDIAG [CLOG] renameat_until_success_ (ob_server_log_block_mgr.cpp:1375) [16589][T1007_L0_G0][T1007][YB4A0A000407-00060B310E94B152-0-0] [lt=6][errcode=-9100] ::renameat failed(ret=-9100, this={dir::"/home/admin/oceanbase/store/clog/log_pool",
ERROR issue_dba_error (ob_log.cpp:1866) [2582][T1001_IOWorker][T1001][Y0-0000000000000000-0-0] [lt=12][errcode=-4388] Unexpected internal error happen, please checkout the internal errcode(errcode=-9100, file="ob_server_log_block_mgr.cpp", line_no=1375, info="::renameat failed")可能原因
错误码:-9100,是存储层找不到对应的目录或者文件,结合服务器重启,可能是:
- 磁盘挂载异常,例如数据或日志盘未挂载上。
- 存储层目录设置文件系统是临时文件格式,例如存放到/tmp 目录下。
- 有人为删除过存储层文件等。
解决方案
- 检查挂载信息,或手动 mkdir 测试创建目录是否有权限相关问题。
- OB 推荐使用 ext4 或 XFS 文件系统。
- OB 数据存储目录文件不能删除,删除无法恢复,只能重装该节点 ob 服务。
问题现象
OB4.2 查询归档历史 CDB_OB_ARCHIVELOG_SUMMARY 视图,部分租户只有一条记录,且 ROUND_ID=1,有些租户多个 ROUND_ID。
可能原因
租户有多个 round_id 是出现过日志断流或者日志归档启停,每次日志归档重新启动会生成性的 round_id。
解决方案
并不影响使用,只要日志归档状态是 doing,即正常状态。
问题现象
OCP4.0.3 上传软件包失败,搭建有 nginx 转发 OCP 地址,nginx 有报错:
client intended to send too large body: 89964166 bytes。可能原因
可能是 nginx 的 client_max_body_size 参数限制导致。
解决方案
可调整 nginx 参数 client_max_body_size 1024M; 和 proxy_read_timeout 300s;
问题现象
OB4.2 备租户恢复报错:
Error 4018: No enough log for restore。可能原因
恢复的归档时间参数超出备份时间范围。
解决方案
select * from CDB_OB_BACKUP_SET_FILES where tenant_id=xxx;select * from CDB_OB_ARCHIVELOG where tenant_id=xxx;select * from CDB_OB_RESTORE_HISTORY where tenant_id=xxx;需要满足: restore_scn
>=备份集的 min_restore_scn restore_scn<=日志归档的 checkpoint_scn
问题现象
OB4.2 使用带参数的存储过程,首次调用慢。
可能原因
可能是执行计划缓存被淘汰了。
解决方案
可以调大租户的 ob_plan_cache_percentage 参数,增加执行计划缓存空间。
问题现象
OB4.1 合并卡住,observer.log 报错:
ERROR try_recycle_blocks (palf_env_impl.cpp:692) [1042160][T1001_PalfGC][T1001][Y0-0000000000000000-0-0] [lt=16][errcode=-4264] Log out of disk space(msg=“log disk space is almost full”, ret=-4264可能原因
看报错是日志磁盘满,导致回放卡住后无法合并。
解决方案
可以增大 log_disk_size 或者重启该节点 ob 服务。但该案例引发 clog 磁盘满的是根因是磁盘设置 raid 缓存模式是 write back,此为 intel 的 cache bug,需要设置为 write through 规避。
问题现象
部署 OB4.2.0 失败,observer.log 报错:
[errcode=-4388] Unexpected internal error happen, please checkout the internal errcode(errcode=-4009, file="main.cpp", line_no=588, info="observer start fail")。可能原因
报错码:-4009,日志中还有报错:
convert sys errno(ret=-4009, errno=27, errmsg="File too large"),和磁盘申请空间相关,用户使用 OBD 白屏部署时使用最大使用模式部署,由于磁盘规格过大,一次性申请到的磁盘资源超出内存数倍规格发生报错。解决方案
部署时指定 datafile_size 参数大小,避免一次性申请太大,部署完成后,可以再调大该参数。
问题现象
.NET framework 框架连接 OB4.2 版本失败,使用 mysql-for-visualstudio-2.0.5 驱动,报错:
using method 'mysql_native_password' failed with message:Reading from the stream has failed。可能原因
已知的驱动问题。
解决方案
- 尝试下使用 MySql.Data.MySqlClient .Net Core Class Library 8.0.22 版本来规避。
- 或者使用第三方 MySqlConnector 驱动来连接即可。官网:
https://mysqlconnector.net,代码中直接在 nuget 里加载组件,把原来的 Mysql.Data 卸载掉。
问题现象
OB4.2.0 创建用户的语法报错:
near 'mysql_native_password'。可能原因
OB 暂不支持 mysql_native_password 语法。
解决方案
建议手动修改创建语句进行用户创建。
问题现象
OB3.1.5 扩容新节点失败,observer.log 报错:
ERROR [LIB] start (thread.cpp:107) [357097][0][Y0-0000000000000000] [lt=14] [dc=0] pthread create failed(pret=11, errno=11)。可能原因
创建线程失败,可能和用户进程数限制相关。使用 observer 的进程用户 ulimit -a 确认 max user processes 大小,推荐配置:655360。
解决方案
在/etc/security/limits.conf 配置配置用户最大进程数限制。
问题现象
OB3.1.3 进行 replace into 大数据量耗时很长。
可能原因
replace 暂时不支持并发,该版本执行慢基本符合预期。
解决方案
可以业务上改造成 insert 方式,或者同时升级 OB3.1.4,使用并行导入功能提升性能。
问题现象
使用 datagrip 连接 oceanbase 报错:
The server time_zone 'GMT+8:00' defined in the 'serverTimezone' parameter cannot be parsed by java TimeZone implementation. See java.util.TimeZone#getAvailableIDs() for available TimeZone, depending on your JRE implementation。可能原因
工具的时区和 OB 不一致。
解决方案
可以参考:
https://blog.csdn.net/ethan__xu/article/details/111149561设置 datagrip 时区。
问题现象
OB4.1.0 使用
'01'数据 update 更新表中的 decimal(2,2)字段报错:ERROR 1264 (22003): Out of range value for column。可能原因
符合 decimal(2,2)有效数值范围。
解决方案
decimal(2, 2) 中第一个 2 的含义是说这个 decimal 整数位+小数位一共最多有两位有效数字,第二个 2 的含义是说这个 decimal 小数点儿后最多有两位有效数字,这样整数位最多就只有 2 - 2 = 0 位有效数字。所以这个 decimal(2, 2) 只能存绝对值小于 1 的小数,不能有整数位的。
问题现象
Docker 部署 OB,删除容器后无法启动,日志提示:
cat: /root/obagent/run/ob_mgragent.pid: No such file or directory。可能原因
容器使用 obd 部署的 OB,存在其他组件未挂载目录,导致无法找到组件文件。
解决方案
除了挂载/root/ob 和/root/.obd 外,还要把/root/obagent 挂载,然后
rm -rf /root/obagent/run/*,能成功重启。
问题现象
OB4.1 进行 TPCC 压测报错:
"parameter index out of bounds. 38929 is not between valid values of 1 adn 38928"。可能原因
JDBC 需要设置批处理参数。
解决方案
JDBC 设置 allowMultiQueries=true 参数,可以执行批处理,同时发出多个 SQL 语句。
问题现象
obcdc 读取 TINYINT 类型的数据报错,STRING 类型不报错,但是会读取到数据为 true/false。
可能原因
OB 中关键字 BOOL/BOOLEAN 是 TINYINT 的同义词。OB 中 TINYINT(1) 对应 flink cdc 中 BOOLEAN 类型。
解决方案
修改要同步表的 TINYINT 字段长度,将 TINYINT(1)修改为 TINYINT(2),这样可以临时规避解决。
问题现象
使用 mysql 客户端连接 OB4.2,load data 加载数据报错:
ERROR 1227 (42501): access denied。可能原因
OB4.x load data 增加了安全策略。
解决方案
使用 obclient 客户端通过 socket 文件连接 OBSERVER 的用户租户。同时注意修改目录权限:
set global secure_file_priv = '/path_name';
问题现象
miniob 编译的时候报错 cmark 命令错误,报错:
build.sh: line 83: cmake: command not found。可能原因
cmark 命令安装的用户和编译用户不一致。
解决方案
尝试添加一下 cmake 到系统的 PATH 环境变量中
sudo admin ~/.bashrc文件末尾增加:export PATH="/path/to/cmake/bin:$PATH"执行:source ~/.bashrc
问题现象
OB4.x 使用 mybatisplus 的 updateBatchById 方法报错:
Cause: java.sql.SQLException: Not supported feature or function。可能原因
jdbc 连接池配置问题。
解决方案
JDBC 连接池配置: rewriteBatchedStatements:true
allowMultiQueries:true
OCP 部署问题
问题现象
部署 OCP V3.3.0 时报错
1146(42S02):Table‘meta_database.compute_vpc’ doesn’t exist。可能原因
这是 OCP V3.3.0 的已知 bug 问题,已发布 bp 版本中已经修复。
解决方案
可以先在 ocp meta 租户的库中确认是否已经存在 compute_vpc 表,如果存在,把其他的表删除,仅保留 compute_vpc,之后重新初始化 OCP。
问题现象
部署 OCP V3.3.0 时报错
resource not enough:memory(Avail:1.6G,Need:8.0G)。可能原因
memory_limit 默认使用物理总内存 80%,但如果可用内存不足,会出现创建租户时申请不到资源。
解决方案
可在 custom_config 模块中将 memory_limit 设置为服务器可用内存范围以内(可执行
free -g命令查询内存)。
问题现象
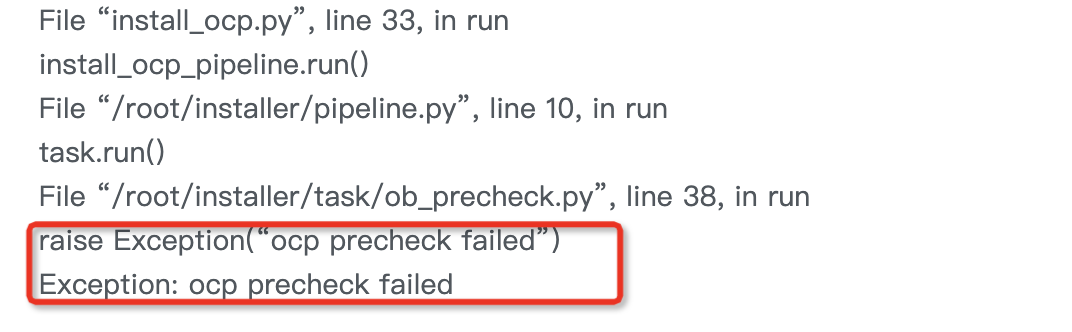
部署 OCP V4.0.0 时报错预检测失败:
ocp precheck failed。可能原因
预检测会检查服务器硬件资源是否符合生产环境标准,如果不通过会报此错误,测试环境建议关闭预检测功能。
解决方案
关闭预检参数,即将 precheck_ignore 设置为 true。
问题现象
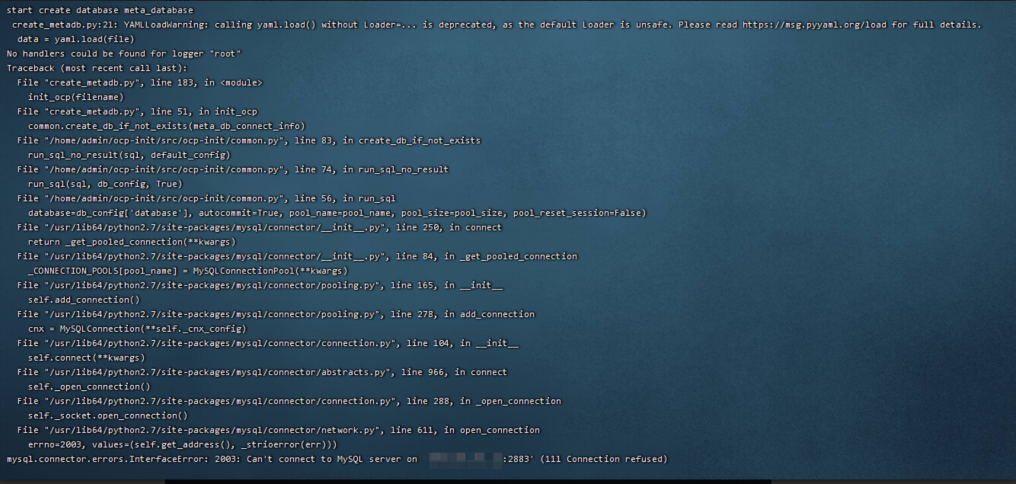
部署 OCP V3.3.0 是报错无法连接到 metadb:
2003:Can't connect to MySQL on 'xx.xx.xx.xx' (111 Connection refused)。可能原因
create_metadb_cluster 参数默认为 false,会使用配置中 ob_cluster 模块信息当 metadb,可能是实际操作中 metadb 不存在。
解决方案
配置文件 create_metadb_cluster 设置为 true,默认安装个 metadb 数据库。
问题现象
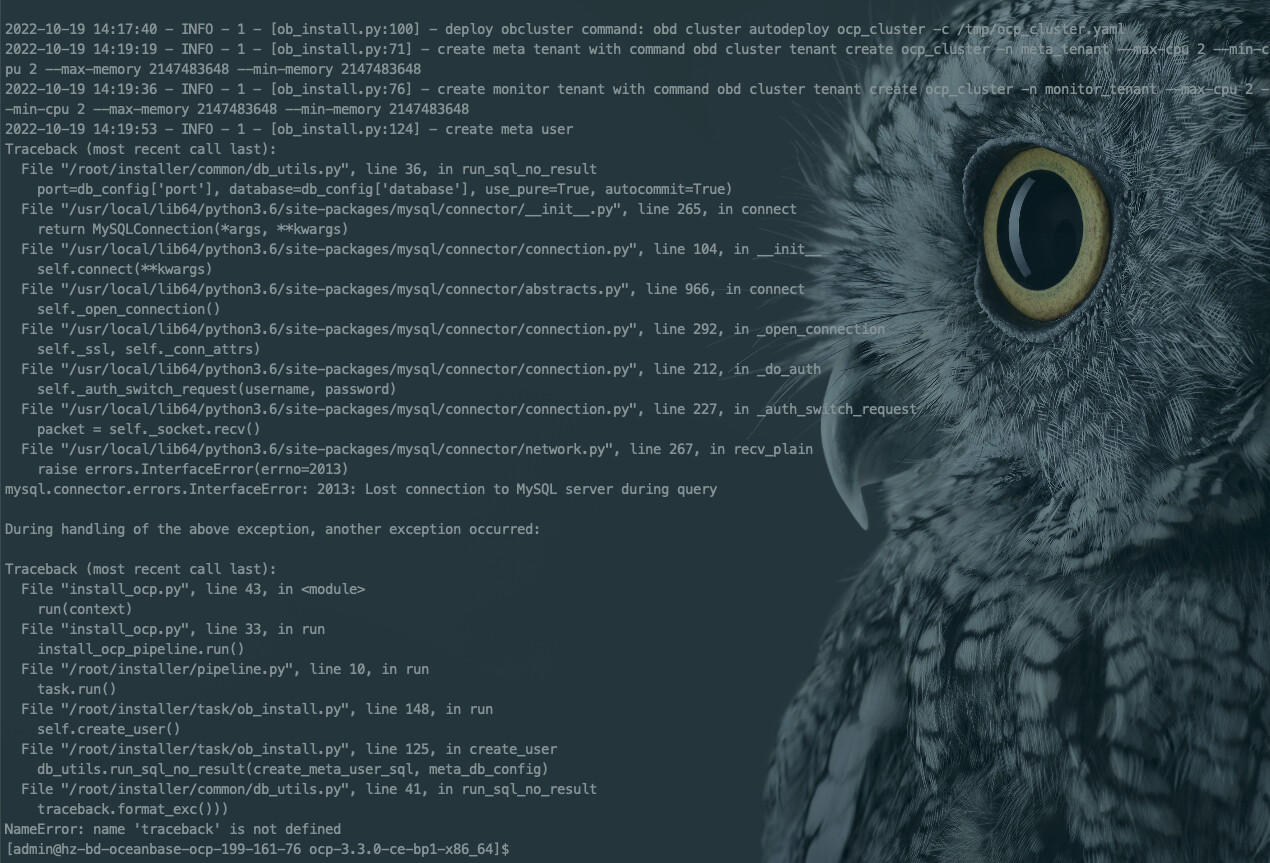
OCP V3.3.0 部署过程中,create meta user 阶段报错
NameError: name ‘traceback’ is not defined。可能原因
可能是找不到对应的文件导致,删除重新部署会产生新的文件。
解决方案
检查
/tmp目录下是否有precheck-*.sh文件(-*是当时生成的 uuid),如果有,删除即可。
OCP 使用问题
问题现象
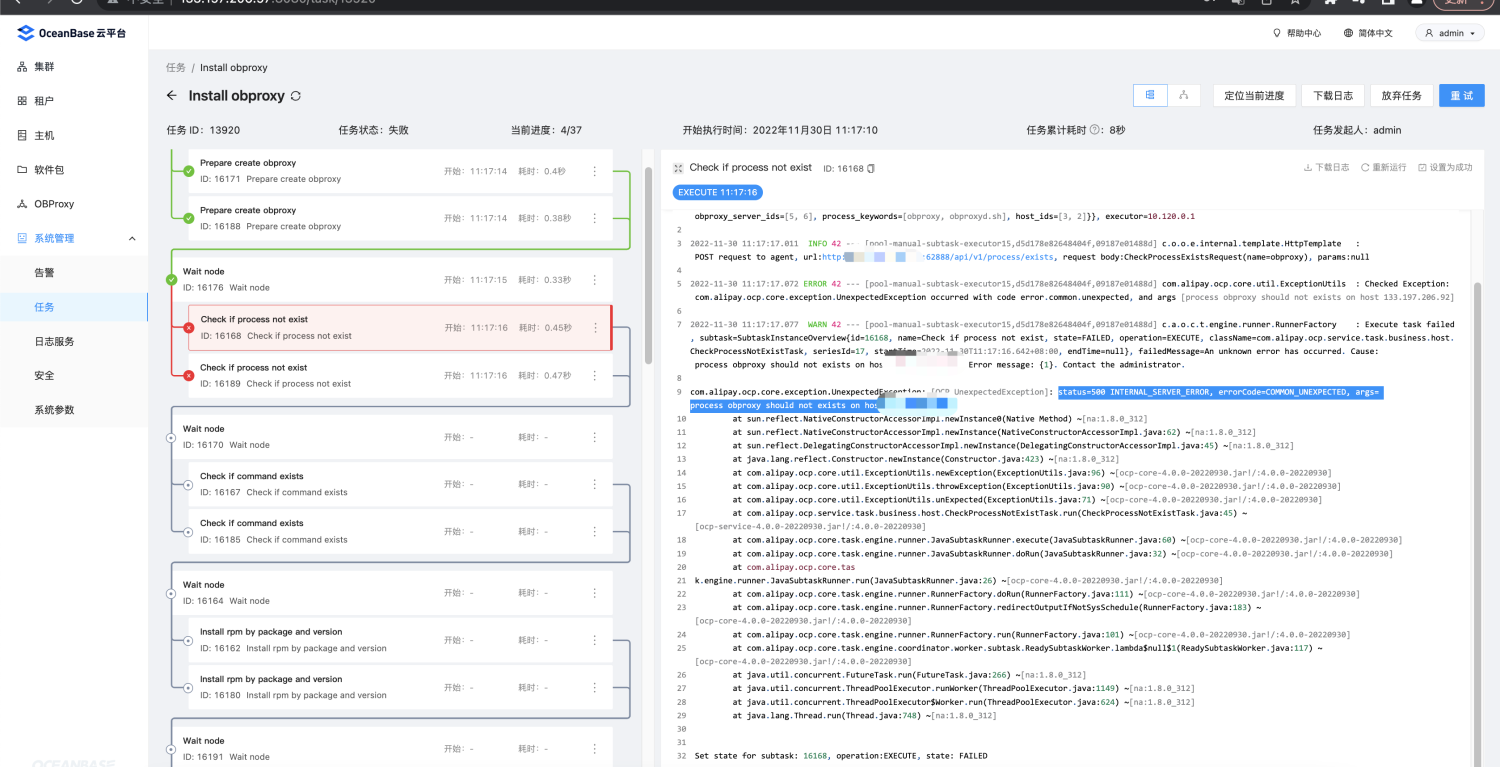
使用 OCP V4.0.0 部署 OBProxy 时,check if process not exit 阶段失败,报错:
status=500 INTERNAL_SERVER_ERROR, errorCode=COMMON_UNEXPECTED, args=process obproxy should not exists on host。可能原因
该节点已存在 OBProxy 服务和进程。
解决方案
更换默认的 2883 端口,或者卸载该节点已经部署的 OBProxy 服务。
问题现象
使用 OCP 接管时报错 observer 进程属于 root,需要使用 admin 账号。
可能原因
OCP 接管限制中,要求 observer 进程启动用户必须是 admin。
解决方案
接管的详细操作可参见 SOP 文档 【SOP 系列 07】如何使用 OCP 接管 OBD 部署的 OceanBase 集群
问题现象
OCP V4.0.0 部署集群时卡在 Bootstrap ob 阶段,日志提示
try adjust config ‘memory_limit’ or ‘system_memory’。可能原因
system_memory 默认是 30G,memory_limit_percentage 默认是占用 80% 的物理内存,如果不指定这两个参数配置信息,小规格服务器配置可能出现申请不到内存问题。
解决方案
调小 memory_limit 和 system_memory 参数。
问题现象
OCP 部署 OceanBase V3.1.4 集群时 bootstrap ob 失败,查看日志显示
ERROR [CLOG] update_free_quota (ob_log_file_pool.cpp:465) [77084][0][Y0-0000000000000000] [lt=3] [dc=0] clog disk is almost full(type_=0, total_size=1888745000960, free_quota=-198549053440, warn_percent(%)=80, limit_percent=95, used_percent(%)=90)。可能原因
OceanBase 数据库中数据文件采用预占用方式,同盘会出现磁盘空间不足问题,生产环境必须分盘,测试环境可降低占用比例。
解决方案
使用 OCP 部署集群时安装路径参数 home_path 、data、redo 采用分盘部署,不要混部到一块盘上,如果是简单测试,可以把 datafile_size 或者 datafile_disk_percentage 调小。
问题现象
使用 OCP V3.3.0 部署 OceanBase 数据库时,Pre check for install ob 阶段异常,报错
ob install pre check failed,maybe from another observer。可能原因
OCP 不支持在已有 observer 进程的集群环境再部署一套 OceanBase 集群。
解决方案
卸载 OBServer 节点上的 observer 进程,或者使用未部署过 OceanBase 数据库的资源环境。
问题现象
使用 OCP V3.3.0 接管 V3.1.4 OceanBase 集群时,使用 proxy 连接 OCP 报错 OBProxy proxyro 用户密码与 OCP 设置不相同。
可能原因
OCP 初始的 proxyro 密码是空,如果 OceanBase 集群中设置了 proxyro 密码,需要 OCP 也保持一致。
解决方案
执行如下命令修改 OCP 中 proxyro 密码。
curl --user admin:aaAA11__ -X POST "<http://xx.xx.xx.xx:8080/api/v2/obproxy/password>" -H "Content-Type:application/json" -d '{"username":"proxyro","password":"*****"}'
--user后需填写 OCP 白屏登录用户:密码,xx.xx.xx.xx:8080为 OCP 地址:端口*****为 OBD 部署配置文件中 observer_sys_password 参数的密码。
问题现象
使用 OCP V4.0.3 接管 OBD 部署的 4.x 版本 OceanBase 数据库时,报错 OBProxy proxyro 用户密码与 OCP 设置不相同。
可能原因
OCP V4.0.3 废弃了 /api/v2/obproxy/password 接口,无法通过接口方式保持两端密码一致。后续版本会优化。
解决方式
方案 1: 可执行
obd cluster edit-config 部署名称命令修改 proxyro_password 和 observer_sys_password 一致为*********,保存修改后再执行obd cluster reload 部署名称命令即可。方案 2:
- proxy 里面改(2883 端口,root@proxysys)
alter proxyconfig set observer_sys_password = '*********';- 直连 observer,sys 租户改 proxyro 用户的密码跟上面一致
set password for proxyro=password('********* ');
问题现象
OceanBase 数据库 V3.1.4 在业务租户有批量或者手工导数期间,偶然性会有告警
plan cache memory used reach limit。可能原因
如果租户内存设置太小,或者批量导数条数不一致可能出现此类报错。
解决方案
扩容租户内存或执行如下命令调整 ob_plan_cache_percentage 阈值。
show variables like'%ob_plan_cache_percentage%'; set global ob_plan_cache_percentage =10;
问题现象
使用 OCP 接管 OceanBase V4.0.0 集群时报错所在 IDC 与目标 OBServer 的 IDC 不匹配。
可能原因
因为接管前已经人为将节点添加到主机列表中,列表中的 IDC 机房和 Region 地区信息和接管的集群默认信息不一致。
解决方案
主机列表删掉对应的节点信息,重新接管。也可以登录 OceanBase 数据库通过 SQL 修改 IDC 和 Region 信息。
alter system alter zone 'zone1' set idc = 'xx;alter system alter zone 'zone1' set region = 'xx';
问题现象
OCP 上创建的 unit 规格配置不显示。
可能原因
小于 5G 的 Unit 规格在前端展示的时候会被过滤掉。
解决方案
连接 OCP 的 meta 租户,查看该限制的控制参数:
select * from config_properties where key like ‘%small%’ \G。在特殊情况下,比如 demo 演示等非生产环境中,可以将其改为 true,就会取消这个限制,命令如下。UPDATE config_properties SET value='true' WHERE `key` = 'ocp.operation.ob.tenant.allow-small-unit';
问题现象
OCP V4.0.3 中添加主机,无法安装 ocp agent 服务。
报错:
args:/tmp/8c76f061414e4d6/pos.py uninstall_package ^t-oceanbase-ocp-agent, return code:2, output:failed to call pos: func=uninstall_package, args=['^t-oceanbase-ocp-agent'], code=2, output=/tmp/a463f6de-fde4-11ed-8e6e-fefcfeb8fb: line 1: unexpected EOF while looking for matching。可能原因
示例中使用的是 Centos7 系统,安装 ocp-agent 前会做操作系统检查,可能因为 dpkg 命令会错误的判断现场操作系统类型。
解决方案
执行如下命令卸载 dpkg 命令。
rpm -qa|grep dpkg , rpm -e --nodeps $dpkg
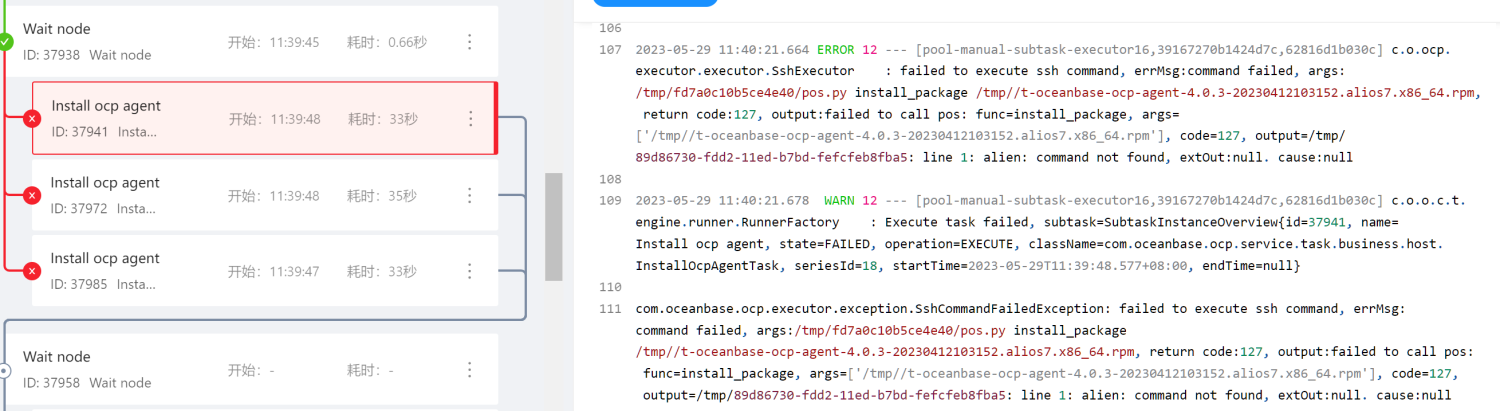
问题现象
使用 OCP V4.0 添加主机报错,白屏页面显示没有找到指定 OCP Agent 类型的记录。
报错:No route to host (Host unreachable)
可能原因
待添加的主机防火墙开启,安装程序路由不到该节点。
解决方案
关闭待添加主机的防火墙即可。
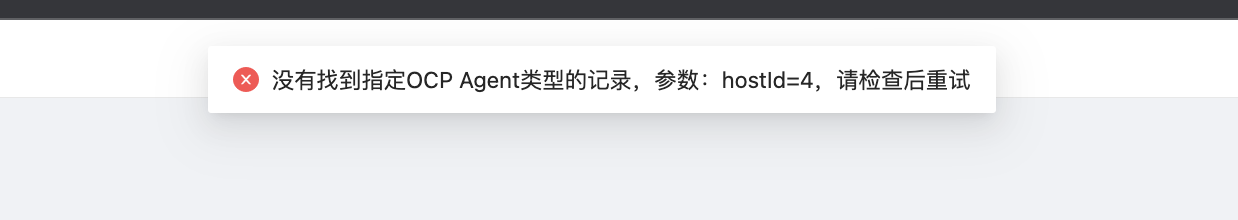
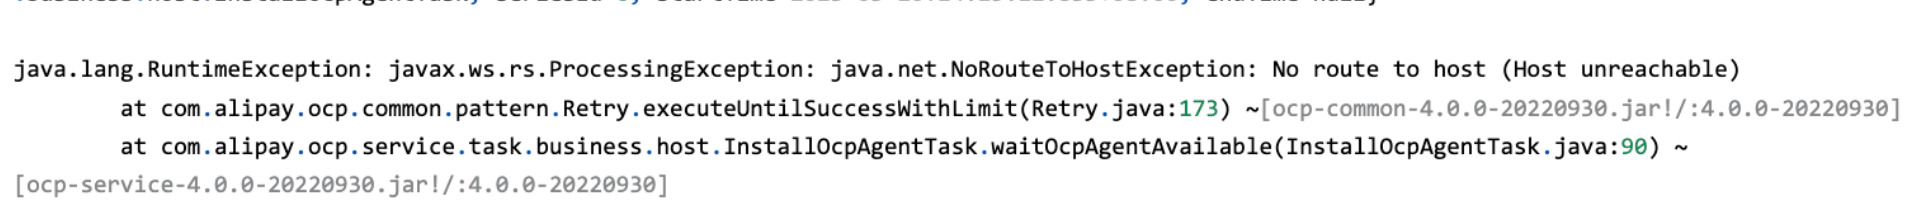
问题现象
使用 OCP 部署 OceanBase 数据库 V3.1.2,使用 root 用户后台启动 observer 后,再重新使用 admin 用户启动失败。。查看日志报错如下。
ERROR [COMMON] inner_open_fd (ob_log_disk_manager.cpp:1043) [5889][0][Y0-0000000000000000] [lt=5] [dc=0] open file fail(ret=-4009, fname="/home/admin/oceanbase/store/lzq/slog/4", flag=1069122, errno=13, errmsg="Permission denied")
ERROR [SERVER] init (ob_server.cpp:172) [4195][0][Y0-0000000000000000] [lt=2] init config fail(ret=-4009)
可能原因
OCP 部署或接管的 OceanBase 集群均是 admin 用户权限,使用 root 启用后会导致 observer.conf.bin 文件和 redo 日志目录下的文件权限变更,无法再使用 admin 启动成功。
解决方案
执行如下命令修改所有 OBServer 节点目录的权限。
chown -R admin.admin /home/admin/oceanbase/
chown -R admin.admin /data/1
chown -R admin.admin /data/log1
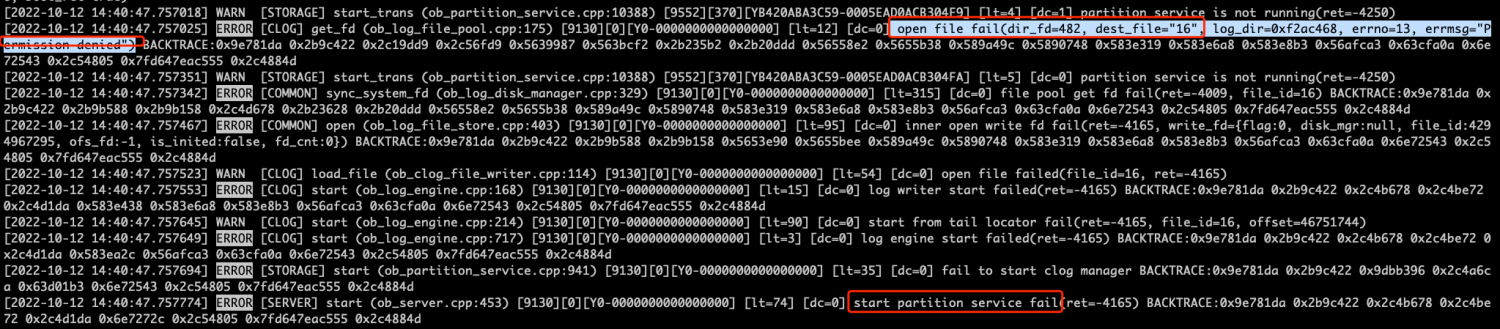
问题现象
使用 OCP V3.3.0 部署 OceanBase 数据库时安装路径检测失败。
可能原因
安装目录和数据目录没有 admin 用户权限。
解决方案
可执行如下命令为安装目录和数据目录赋予 admin 用户权限。
chown -R admin:admin /data && chown -R admin:admin /redo && chown -R admin:admin /home/admin
问题现象
使用 OCP V3.3.0 接管使用 OBD 部署的 OceanBase V4.0.0 集群时失败,报错
(conn=10) Table 'oceanbase.v$ob_cluster' doesn't exist。可能原因
OceanBase 数据库 4.0.0.0 版本相较 3.x 版本架构变动较大,部分系统表进行调整,使用不配套的 OCP 版本无法接管。
解决方案
可升级 OCP 版本到 V4.0.0。
问题现象
无法使用 OCP 把管理的 OceanBase 数据库移除。
适用版本
OCP 3.x、4.x 版本。
可能原因
OCP 暂不支持迁出部署和接管的集群,但可以使用接口实现,并且迁出的集群不管是使用 OBD 部署的还是使用 OCP 部署的,均支持再次接管。后续版本会增加迁出集群功能。
解决方案
可以通过调用后端 restful api 的方式来迁出 OceanBase 数据库集群。命令如下:
curl -X POST --user {user}:{password} -H "Content-Type:application/json" -d '{}' "http://{ocp-url}:{port}/api/v2/ob/clusters/{cluster_id}/moveOut"
# example
curl -X POST --user admin:aaAA11__ -H "Content-Type:application/json" -d '{}' "<http://10.10.10.1:8080/api/v2/ob/clusters/2/moveOut>"
需注意的是,命令中的 cluster_id 指的是 OCP 浏览器地址中的集群 ID,例如 xx.xx.xx.xx:8080/cluster/2,表示 cluster_id 是 2。
问题现象
使用 OCP V3.3.0 重启 OceanBase(V3.1.4)集群被卡住,该集群使用 OBD 可正常重启。
查看日志报错:Connect to xx.xx.xx.xx:62888 [/xx.xx.xx.xx] failed: Connection refused (Connection refused)
可能原因
ocp-agent 服务的端口为 62888,查看日志显示报错连接被拒绝,基本为 ocp-agent 服务异常无法通过 agent 服务下发指令导致。
解决方案
重启主机节点的 ocp-agent 服务。
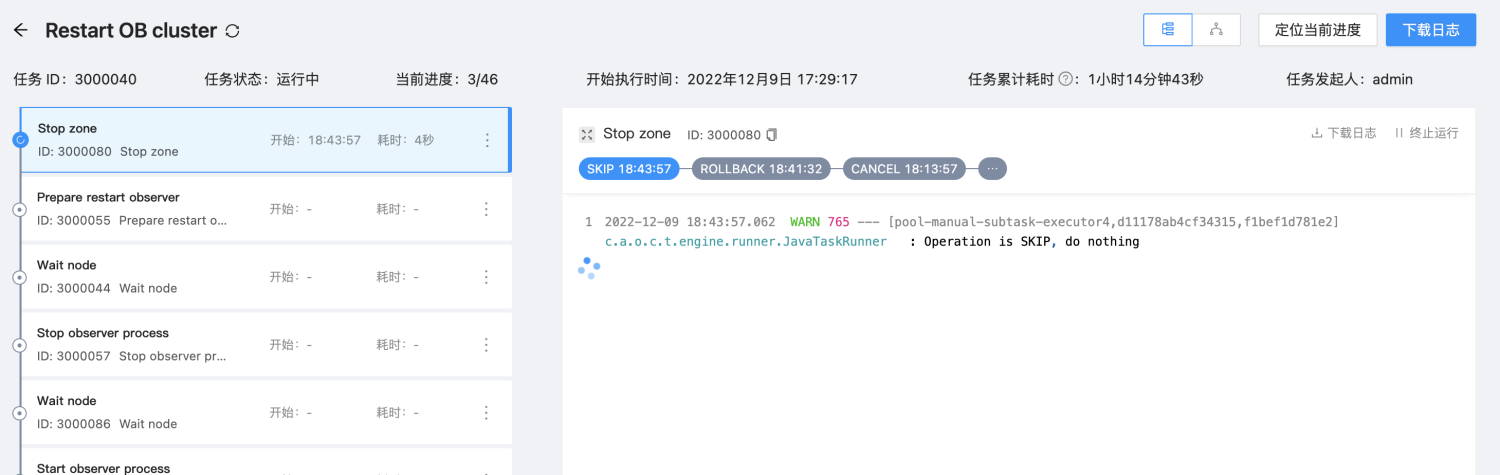
问题现象
使用 OCP V4.0 关闭集群页面报错:集群 obcluster 不允许进行操作。
可能原因
OCP 的 metadb 被 OCP 自身接管,如果使用 OCP 管理该集群会导致 OCP 服务不可用。
解决方案
不能使用 OCP 停止接管的 metadb。
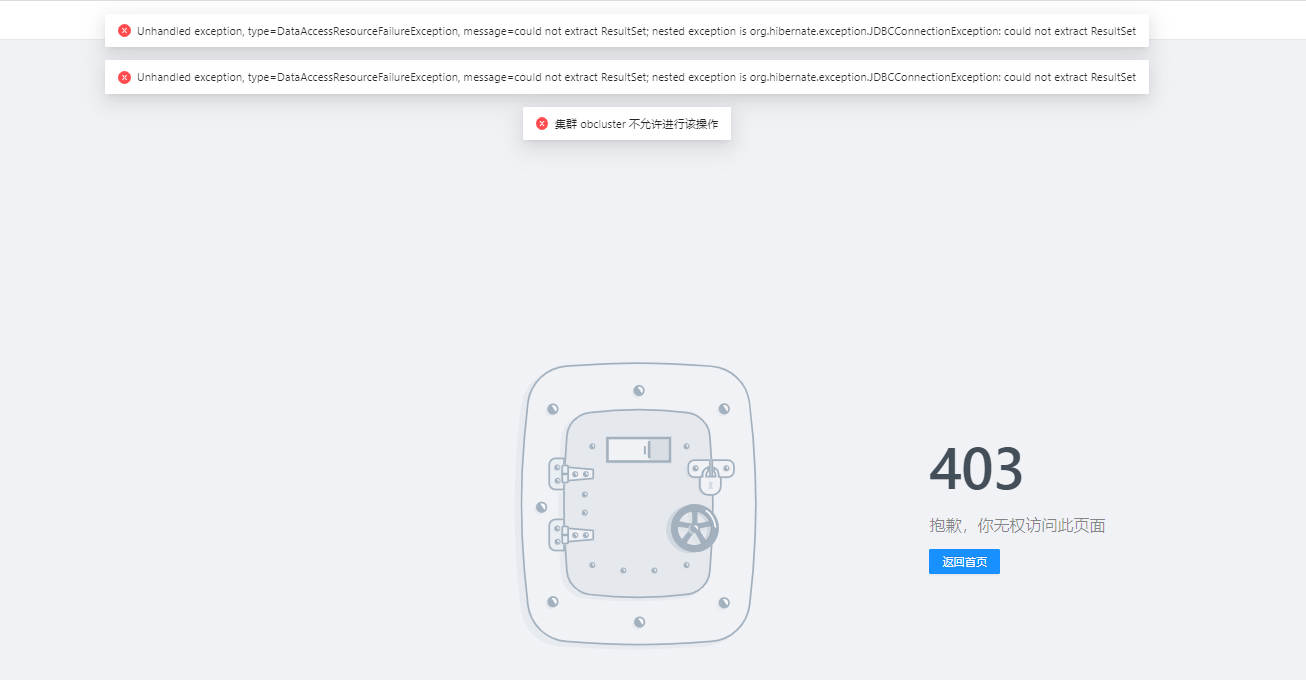
问题现象
使用 OCP 4.x 版本删除租户下的 test1 库,提示不允许进行该操作。
可能原因
此集群和 metadb 共用,OCP metadb 默认是不允许通过 OCP 做运维操作的。
解决方案
OCP meta 租户下执行如下命令将黑名单对应的 value 置空。
update config_properties set value='' where `key`='ocp.ob.cluster.ops.blacklist';
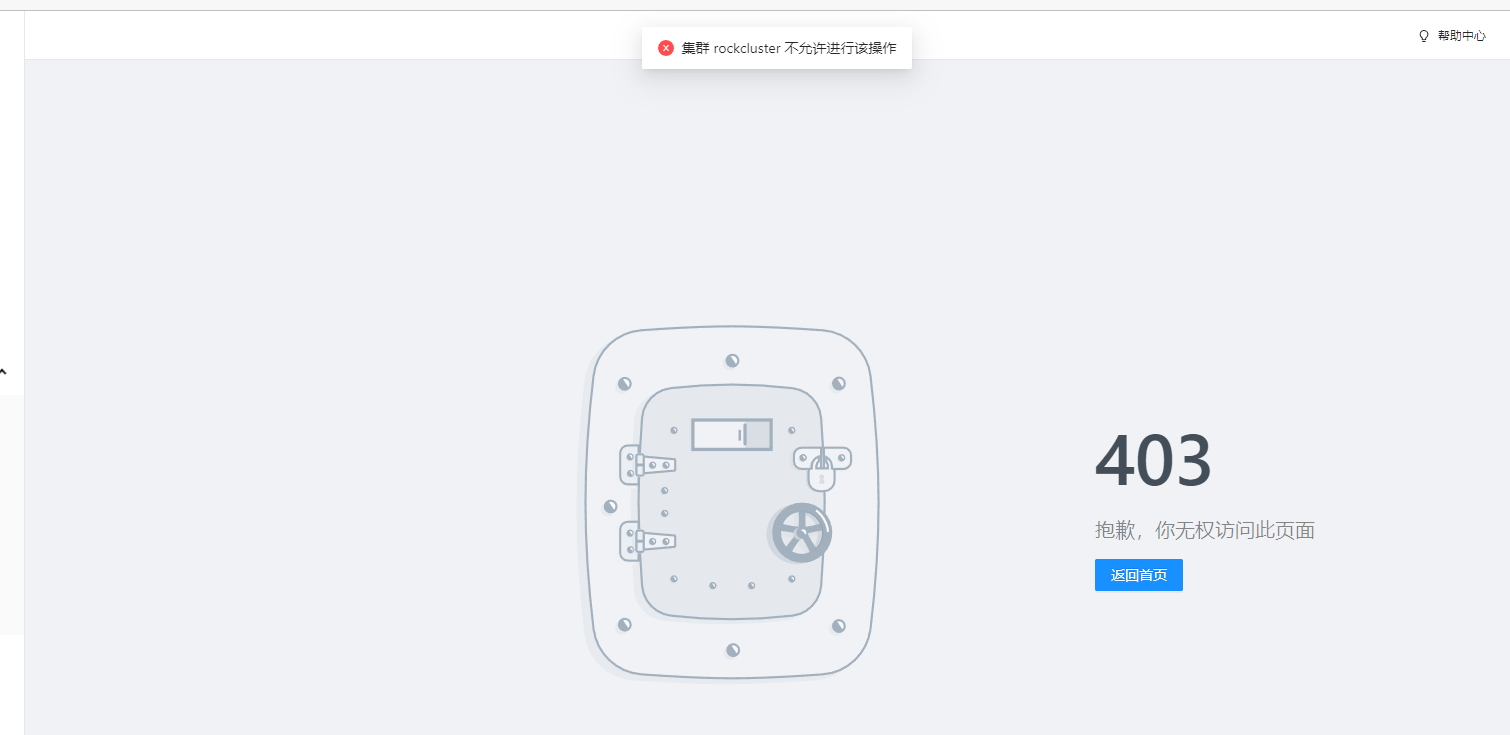
问题现象
将 OCP 从 V3.1.1 升级至 V3.3.0 时失败,报错 yaml 格式不正确。
可能原因
OCP V3.1.1 和 V3.3.0 的配置文件格式差异较大,升级需要使用 V3.3.0 的配置格式。
解决方案
按 OCP V3.3.0 的配置模版文件改写。
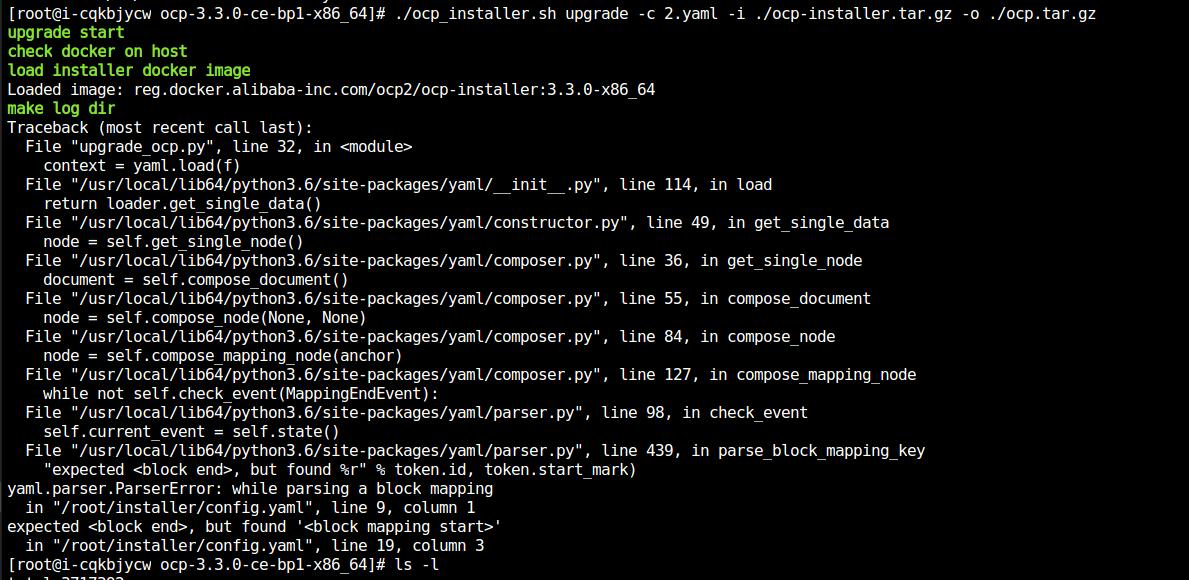
问题现象
将 OCP 从 V3.1.1 升级至 V3.3.0 报错
Can't connect to MySQL server on xx.xx.xx.xx:2881(-2 Name or server not know)。
可能原因
OCP V3.1.1 配置是直连方案,V3.3.0 配置是 proxy 连接方案,升级需要保持原方案,直连时用户名不能带集群名称,否则会被误把 “租户#集群名称” 解析成租户。
解决方案
在 yaml 配置文件 metadb 模块使用直连方式,去掉租户的
#集群名称。
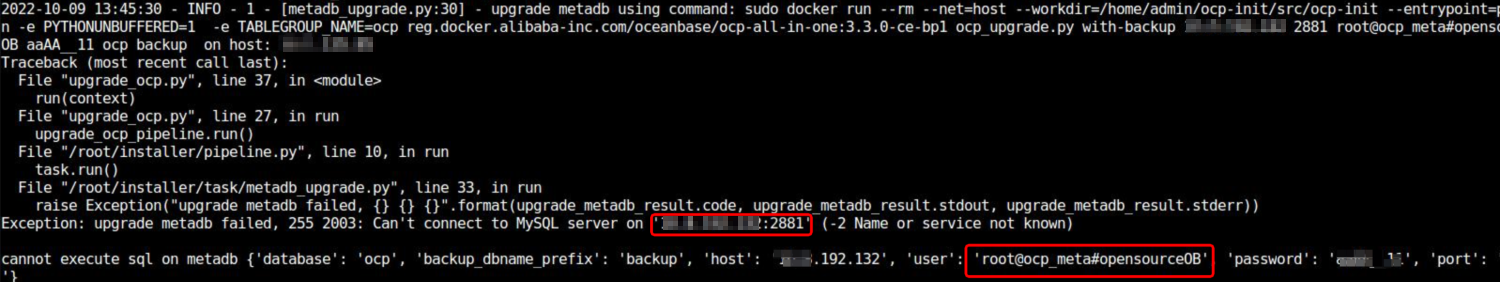
问题现象
将 OCP 从 V3.3.0 升级到 V4.0.0 报错
KeyError: 'buildVersion'。
可能原因
升级需要调用接口连接 OCP,使用的账户为配置文件中的 auth 模块信息,auth 模块配置只有升级过程会用到。如果通过 OCP 白屏修改过登录密码,该配置中也需同步修改。
解决方案
cinfig.yaml 文件 auth 模块的信息改为 OCP 白屏登录用户和密码。
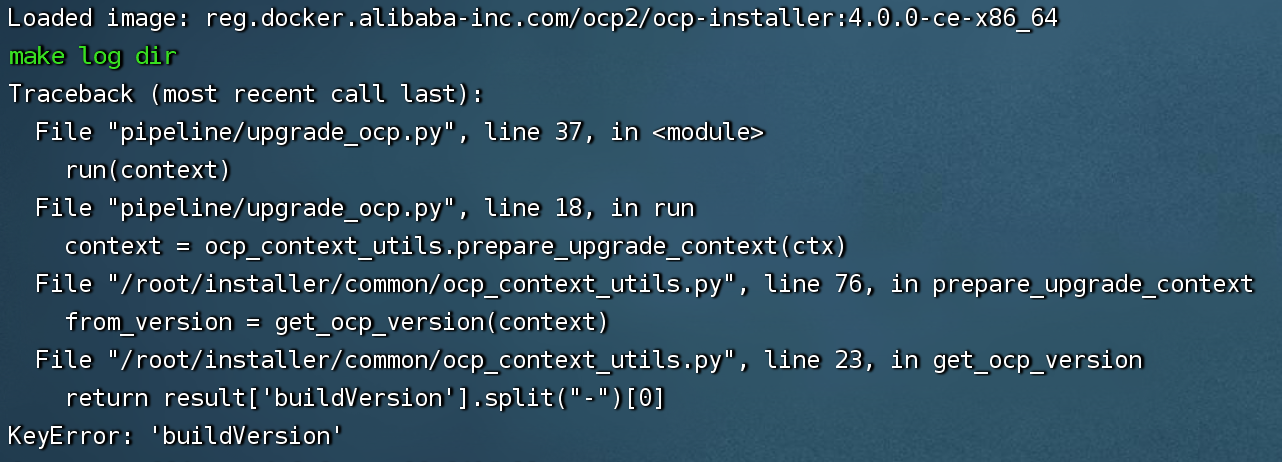
问题现象
OCP4.0.3 上扩容 OB4.0 节点,在启动 OB 阶段 start observer process with param 失败,obsever.log 日志报错
server available memory is little than unit min memory, can not create sys tenant. try adjust config 'memory_limit' or 'system_memory'.(ret=-4147, ret="OB_INVALID_CONFIG", unit_min_memory=1073741824, server_avail_memory=-5372854272, system_memory=32212254720, server_memory_limit=26839400448)可能原因
报错在创建扩容节点的 sys 租户时 system_memory 过大,超出了 memory_limit 内存总量。 主要是内存资源分配有问题,可能是扩容节点的资源配置和原集群不一致或差异较大。也可能是扩容时 OCP 传参的资源参数不正确导致。 meta 租户登录 metadb 查询 mate_database 库下的 ob_cluster 表的 startup_parameters 字段,即原集群首次部署时初始化资源配置,查看资源和当前集群是否保持一致。
解决方案
经过确认为 OCP 部署 OB 后,重新调整了资源参数,修改上述 ob_cluster 表信息和实际集群资源一致即可。
问题现象
OCP4.0.3 版本 metadb 的连接池占满,ocp.log 报错:
active 100,maxActive 100可能原因
1)ocp 的 metadb 资源存在瓶颈导致查询性能慢,造成连接阻塞。例如使用 sata 磁盘,cpu 分配太小等。 2)ocp 管理上百个租户,造成采集数据较多,资源和数据不成正比。需要增加配置或降低监控数据保留周期。
解决方案
- 方法 1: meta 租户设置 spring.datasource.druid.maxActive 连接池调大
update config_properties set value = '200' where key = 'spring.datasource.druid.maxActive';- 方法 2: ocp 的系统参数中调整历史监控数据保留周期 ocp.monitor.data.retention-days,降低数据量,ocp_metric_data_1 就是秒级数据的保留时间,默认是 8 天。
问题现象
OCP4.0.3BP1 使用 ocp-installer 命令停止 ocp 服务失败,报错
[ERROR] Running Error:'oceanbase-ce'可能原因
ocp-installer 命令缺陷,生成的配置缺少联动,推荐部署或升级 OCP 最新版本。
解决方案
- ocp-installer cluster list 查看 ocp 服务配置文件位置 configuration path。
- ocpmetadb-OCP 服务对应的配置文件路径下有个.date 文件记录状态数据,删除其中 oceanbase-ce 模块内容。
- 重新执行停止命令即可。
问题现象
OCP4.0.3 版本接管 OB 时执行 clockdiff 命令失败,报错
Cannot run program "clockdiff"(in directory ".")可能原因
部分操作系统 普通用户是没有执行 clockdiff 命令权限的,即使普通用户有 sudo 权限,OCP 当前版本并使用 sudo 方式去执行。
解决方案
操作系统 root 执行
setcap cap_net_raw+ep /usr/sbin/clockdiff赋权即可。
问题现象
OCP4.0.3 版本,想删除运维中状态的 OBProxy 集群失败,提示:OBProxy 集群[xxxx]的状态不合法:[LOCK],不允许该操作
可能原因
运维中状态是不允许做删除操作的,防止正在执行的任务受影响。
解决方案
如果确认删除组件无影响,可以登录 ocp 的 meta 租户查看在 meta_database 库下的 obporxy_cluster 表,将 status 字段 lock,改 unlock,然后 ocp 上任务删掉 obproxy。
问题现象
OCP 升级到 4.2.0 后部署 OB,在 refresh ocp agent config 阶段报错:
key ocp.agent.snapshot.maxsize is not found in config properties。可能原因
ocp420 升级未把主机的 ocp-agent 版本升级上来,ocp421 版本修复。
解决方案
升级 ocp-agent 版本和 ocp 版本保持一致
问题现象
OCP 升级到 4.2.0 后再部署 OBProxy,在 install rpm by package and version 阶段报错:
http request is failed, response:Bad request: 404 not found可能原因
ocp420 升级未把主机的 ocp-agent 版本升级上来,ocp421 版本修复。
解决方案
升级 ocp-agent 版本和 ocp 版本保持一致
问题现象
OCP 升级到 4.2.0 后再部署 OBProxy,在 install rpm by package and version 阶段报错:
message=InvalidKeyException: lllegal key size or default parameters可能原因
密钥长度受限制,java 运行时环境读到的是受限制的 policy 文件,后续版本会做预检查。
https://stackoverflow.com/questions/6481627/java-security-illegal-key-size-or-default-parameters解决方案
升级 jre 版本,注意需要和 JDK 版本对应
问题现象
OCP4.0.3 版本告警 OB 日志有 ERROR 级别报错:
the hold of observer tenant is over the system_memory可能原因
system_memory 是集群的 500 租户内存,此内存也是共享内存,可能会出现内存占满问题。
select tenant_id,svr_ip,sum(hold),sum(used) from __all_virtual_memory_info where tenant_id=500;查看到 hold 和 used 接近上限。解决方案
调大集群 system_memory 参数。
问题现象
OCP 升级到 4.2.0 后接管 OB 在 Wait observer accessible 阶段报错:
ERROR 1045 (42000): Access denied for user 'ocp_monitor'@'xxx.xxx.xxx.xxx' (using password: NO)可能原因
mysql client 如果是 8.0.21 版本不配置--default-auth=mysql_native_password 无法认证登录。该问题已经在 OCP421 版本解决,后续 OCP 将不依赖 mysql 客户端。
解决方案
OB 节点 mysql 客户端升级到 8.0.28 版本,重试升级即可
问题现象
OCP4.2.0 告警
call web service failed,ret=-4216。可能原因
这个报错是 AWR 功能依赖,社区版不支持该功能,OCP421 会关闭。
解决方案
忽略告警或者升级 OCP421 版本。
问题现象
OCP4.2.1 创建 obproxy 时关联 oceanbase 报错:集群 xxx 不允许进行该操作。
可能原因
metadb 默认不支持被 OCP 运维操作的,防止高危操作(例如:重启 metadb),出现 OCP 不可用。 强制支持 metadb 运维方式(不推荐,仅供测试):metadb 下的 meta 租户 meta_database 库下更新操作:
update config_properties set value='' where key='ocp.ob.cluster.ops.blacklist';解决方案
不能关联 OCP 的 metadb,其他业务 OB 集群可关联。
问题现象
OCP 部署 OB4.2.1 初始化失败,
ret=-9102,prepare_dir_and_create_meta_ failed。 observer.log 报错
ERROR issue_dba_error (ob_log.cpp:1866) [2604157][observer][T0][Y0-0000000000000000-0-0] [lt=7][errcode=-4388] Unexpected internal error happen, please checkout the internal errcode(errcode=-9102, file="ob_server_log_block_mgr.cpp", line_no=506, info="prepare_dir_and_create_meta_ failed")可能原因
目录权限相关,日志可以看出来和 mkdir 目录操作相关,建议检查目录权限问题。
解决方案
手动执行
mkdir -p /home/admin/oceanbase/store/xxx/clog创建目录会提示无访问权限。因此需要检查磁盘访问或目录挂载问题。
问题现象
OCP4.2.1 修改 ocp.site.url 参数之后重启不生效,而且重启后参数被还原了。
可能原因
版本缺陷,后续 OBD250 修复,--without_ocp_parameter 参数会跳过 ocp.site.url 参数的初始化。
解决方案
修改 ocp.site.url 参数后,使用如下命令重启 OCP,
obd cluster start xxx --skip-create_tenant
问题现象
OCP4.2.1 重装 ocp-agent 失败,mgragent.log 日志报错:
error=sudo:unknown user:admin可能原因
OCP4.2.2 版本才会解除 ocp-agent 对 admin 用户的强依赖问题。之前的版本 admin 用户为 ocp-agent 创建,但存在环境变量等问题。
解决方案
1)需要在所有机器上创建一下 admin 操作系统用户 2)
cd /home/admin/ocp_agent/bin && ./ocp_agentctl stop3)跳过之前升级自动触发的 reinstall ocp agent 任务 4)在 ocp 主机管理看到对应的机器变成离线 5)在 ocp 主机管理处点击安装新版本 ocp-agent
问题现象
OCP 升级 OB4.2.1 时卡在 execute upgrade post script 阶段,界面报错超时:
"UPGRADE_ALL",timeout。 observer.log 报错:clog disk hang event。可能原因
clog 磁盘写的慢,clog 和 data 共用,使用的机械盘,升级过程中,rs 不断切换,导致升级超时失败。
解决方案
使用 SSD 磁盘且数据盘和日志盘分盘部署。
问题现象
OCP4.2.1 不断告警服务器时钟同步服务不存在,告警信息:服务器时钟同步服务(ntp 或 chrony)不存在。
可能原因
- 未安装同步工具 ntp/chrony。
- 开启了 ipv6 服务,ipv6 开启后,执行 ntpq -pn 命令会返回 tomeout 超时,OCP 检测 ntp 服务失败。
解决方案
- OB 对时间延迟比较敏感,超过 100ms 延迟会将节点踢出集群,因此需要时钟同步。
- 关闭 ipv6。
问题现象
OCP 告警 OB4.1.0 数据备份任务失败,报错:
ERROR 9031 (HY000) : Cannot backup ob replica,错误码:9031。可能原因
该 Replica 正在迁移复制或者是日志副本时,无法提供数据备份的能力,OB4.2 已优化。
解决方案
升级 OB 到 4.2 版本或以上版本。
问题现象
OCP421 不显示 OB 集群监控信息。
可能原因
可能是做过压测,并对集群做过压测优化,把 enable_perf_event 参数关闭了。该参数默认是开启的,用于性能事件的信息收集。
解决方案
OCP 集群参数中将 enable_perf_event 设置为 true。
问题现象
OCP4.2.0 版本,黑屏手动杀掉 OB 的进程后会被自动拉起。
可能原因
OCP420 版本新增功能,会监控守护 OB 进程。
解决方案
如果维护想关闭该功能,登录 ocp_meta 元租户,将 selfcure_contingency_config 表对应的 enabled 改成 0 即可。
问题现象
OCP4.2.1 版本做数据恢复时,不显示源租户信息。
可能原因
- OCP 接管 OBD 部署的 OB,OB 的 bin 目录下缺少运维程序 ob_admin。
- OB 节点 admin 用户环境变量有问题。
解决方案
- 官网下载工具集成包(OceanBase Utils),解压后将 ob_admin 文件上传至 observer 安装目录的 bin 目录下,并赋予同级 observer 文件相同权限即可。
- OCP4.2.2 版本会修复 ocp-agent 依赖 admin 用户问题。
问题现象
使用 OCP4.2.1 升级 OB 时在 Install dependencies 阶段报错:
message = Install software package failed, reason: previous installed package oceanbase-ce-libs prefix not matched. prev: /home, new: /home/admin/observer可能原因
ocp-agent 本地文件可能有问题,后续版本将优化。
解决方案
查看每个 ob 节点的/home/admin/ocp-agent 目录下的 task_store、pkg_store,清理掉 pkg_store 目录下的 oceanbase-ce-libs 包以后,重新执行任务即可。
问题现象
容器部署的 OCP4.2.1 接管 OB 时界面报错:
Unhandled exception, type=IllegalArgumentException, message=Illegal Connect-User '%s': missing '@'可能原因
连接 metadb 时的配置可能不正确,导致接管时验证参数解析错误。
解决方案
OCP 容器将 OCP_METADB_USER 参数增加完整租户信息。 写法:
- 用户名@租户名#集群名称(使用 obproxy 连接 metadb 时)。
- 用户名@租户名(使用直连 metadb 时)。
问题现象
OCP4.2.0 界面会提示错误信息:
Out of range value for column 'MAX_IOPS' : value 2.7670116110564327E19 is not in class java.lang.Long range。可能原因
OB 集群的 sys 租户资源配置的 max_iops 取值越界缺陷,后续版本会修复,不影响使用。
解决方案
sys 租户登录
select * from oceanbase.gv$ob_units;如果 MAX_IOPS 值异常大(9223372936854775807),可以修改 sys 租户的 unit 配置。alter resource unit sys_unit MIN_IOPS=10000,MAX_IOPS=10000;即可。
问题现象
OCP4.0.3 删除主机失败,放弃任务正常,但主机状态显示:删除中。
可能原因
任务回滚信息写入元数据库可能失败。
解决方案
手动更新 metadb 中 ocp_meta 租户的组件状态。
update compute_host set status = 'AVAILABLE' where id='xx';。
OMS 使用问题
问题现象
使用 OMS V3.3.1 在迁移多张大表到 OceanBase 数据库时,checker 组件报错
NNER_ERROR[CM-RESONF000003]: no enough host resource for a CHECKER, reason [host: IP unavailable cause: current memory usage 0.8573829 exceed limited 0.85]。可能原因
迁移大表较多,使用默认的 checker 组件资源过小。
解决方案
迁移项目详情页点击 查看组件监控,更新 checker 配置中的
task.checker_jvm_param调整 jvm 参数。
问题现象
使用 OMS V3.3.0 启动增量同步报错
INVALID_STATUS_ERROR [INVALID_STATUS_ERROR] {“message”:“Not found ocp name from connectInfo: jdbc:oceanbase://xx.xx.xx.xx:2883?allowLoadLocalInfile=false&autoDeserialize=false&allowLocalInfile=false&allowUrlInLocalInfile=false&useSSL=false”}。可能原因
使用 OMS 启动增量任务时没找到 OCP 或者 configUrl,检查一下数据源里有没有配置 OCP 或者 configUrl。
解决方案
在数据源的高级选项里配置 configUrl。
问题现象
OMS4.x 版本增量同步 OB3.x 到 OB3.x 的链路失败,DDL 日志报错
event source process failed: [ not support create table select as option, origin sql:CREATE TABLE AA AS SELECT a,b FROM BB可能原因
OMS 不支持同步 create table as select 语句,因为其操作创建临时表,同步数据量无法规范,对 OMS 性能影响较大,未来也不考虑支持该语法。
解决方案 如果只采取跳过方式只能规避该 sql 语句,后续该表可能涉及其他的 dml 操作同步时,会报错表不存在问题,因此可以直接将表纳入黑名单即可。 查看组件监控->增量同步组件->更新,将 BB 表加入黑名单,
https://www.oceanbase.com/docs/community-oms-cn-1000000000425982
问题现象
OMS4.1 版本表结构迁移失败,报错
Failed to obtain JDBC Connection; nested exception is java.sql.SQLException: interrupt可能原因
表结构一次性迁移太多导致,同时也和资源环境有一定关系。
解决方案
分多个链路分批迁移表结构,或者单链路迁移表数建议不要太多,建议少于 400 个。
问题现象
重装 OMS4.1.1 版本后使用默认用户和密码登录失败,界面报错
OMS_USER_NOT_ACTIVE可能原因
浏览器缓存登录信息和重装的 OMS 有冲突导致。
解决方案
清理浏览器缓存。
问题现象
OMS4.1.0 升级到 OMS4.1.1 后,登录报错鉴权错误。
可能原因
OMS4.1.1 之前的版本不支持升级到 OMS4.1.1 以及以上版本,因为 OMS4.1.1 版本开始由社区版独立分支,元表结构做了较大改动,后续 OMS4.2 版本会做升级不支持拦截。
解决方案
重新部署 OMS4.1.1 版本或新版本。
问题现象
OMS4.0 增量同步失败,JDBCWriter 组件状态停止。界面报错:CM-SCHEOR000021,jdbcwriter 日志报错执行 replace into 语句时超时断开连接 Broken pipe(Write failed)
可能原因
replace into 语法操作的目标表很大事后,会出现写入慢的现象,导致同步超时。
解决方案
修改 OMS 增量组件参数
JDBCWriter.sinkFile.isMysqlReplaceMode=false,重启 JDBCWriter 增量组件。设置这个之后,优化 replace into 语法为 insert ,加速写入。
问题现象
做 OMS HA 高可用中的 store、jdbcWriter 无法切换了。
可能原因
OMS 高可用节点中存在资源使用比例超过 80%,包括磁盘、cpu、内存等,可以在 OMS 机器资源中确认。
解决方案
释放其他链路或者扩容机器资源。
问题现象
OMS4.1 迁移预检查失败,界面报错:TIME_EXCEPTION,操作 PreCheckAction doRunningAction timeout.projectld xxx1 超时。
可能原因
查询
select gmt_modified from oms_step where project_id='xxx1';发现和本地时间不一致,差 8 小时。
解决方案
OMS 元数据库和 OMS 节点需要时间保持一致。
问题现象
OMS4.2.0 表结构迁移报错获取 DDL 失败。 错误码:CHANA-MIGRAT000201。 错误信息:
OBSCHEMA_ERROR:Failed to migrate the tables,We recommend status filtering under the structure migration step for more information。 错误原因:库、表或者视图迁移失败。 /home/admin/logs/ghana/Ghana/dbcat.log 日志报错:Unknow column 'EXPRESSION' in 'field list'可能原因
OB420_BETA_HF1 版本的系统视图缺少 EXPRESSION 字段。
解决方案
OB 源端升级到 OB421 或以上版本。
问题现象
OMS4.1.1 全量迁移 mysql 从库到 ob 链路,从库开启 binlog,但报错:读取 binlog 数据包时出错。 错误原因:提示
please see the master's error log or the manual for GTID_SUBTRACT.可能原因
看报错和 Gtid 参数相关。
解决方案
组件监控,修改 store 组件的配置:mysql2store.useGtid=false。
问题现象
安装 OMS4.2,启动浏览器访问报错:服务器内部错误。 /home/admin/logs/ghana/Ghana/oms-web.log 报错:
Conversion not supported for type java.time.LocalDateTime可能原因
报错是 metadb 元数据库的时间类型转换不支持,如果是 metadb 是 ob 是没问题。OMS 暂时只支持 mysql8 和 oceanbase 作为 metadb。
解决方案
替换 metadb,使用 mysql8 或者 ob 数据库,不支持 mysql5.x。
问题现象
OMS 多次登录失败,提示:密码已锁定,当前用户角色:ADMIN,请联系更高权限用户协助修改密码。
可能原因
OMS 密码输入 5 次不正确会锁登录用户,半小时后可能重试。
解决方案
登录 OMS 的 metadb 元数据库,修改 rm 库的 oms_user 表,将 login_failure_times 和 is_locked 都设置成 0。 或者进入 oms 容器:supervisorctl restart oms_console,重置登录信息。
问题现象
OMS4.1 操作 添加关联 OCP 失败,提示:查询 ocp 版本失败。
可能原因
- 相关 OB 数据源没有使用 OCP 管理。
- 使用 OCP 管理,但 OCP 更新元数据可能不正确。
解决方案
- 使用 OCP 接管数据源或者部署 config-server 服务。
- 可以手动拼写 ocp config_url 信息,ObRegion 是集群名称,其他参数是固定写法:
http://xx.xx.xx.xx:8080/services?Action=ObRootServiceInfo&User_ID=alibaba&UID=ocpmaster&ObRegion=xxxx
问题现象
OMS4.2.0 版本创建数据源报错无法连接,报错:
ERROR 1045 (42000): Access denied for user 'xxx'@'xxx.xxx.xxx.xxx' (using password: YES)。 但使用相同配置黑屏或者 navicat 可以连接。可能原因
可能是 OMS 数据源未使用 obproxy 连接配置。
解决方案
OMS 配置的数据源只能用 obproxy 连接。
OBProxy 问题
问题现象
使用 OBProxy 4.x 版本做大批量插入时候,应用报错
Connection reset by peer。OBProxy 日志中看到报错:
obproxy's memroy is out of limit's 80% !!!可能原因
通过报错信息看是 OBProxy 的内存超出了,但最终问题是现场插入是未做连接回收引发多种问题,可以借鉴。
解决方案
使用 root@proxysys 账号 2883 端口连接到 OBProxy,修改内存大小:
ALTER proxyconfig SET proxy_mem_limited = 6G;。
问题现象
obproxy3.2.3 断开连接,obproxy.log 日志报错:
fail to produce(expected size=0, actual size=2, ret=-4016)。可能原因
server 返回给 obproxy 的包太大时,会导致无法读取完整,produce 函数报错,obproxy4.1 版本修复。
解决方案
升级 obproxy 版本到 4.1 或以上版本。
ODC 问题
问题现象
使用 MAC 安装 ODC V3.3.2 报错
[com.alipay.odc.config.BeanCreateFailedAnalyzer][21]: bean create failed。可能原因
有可能是 JAVA 版本的问题。
解决方案
推荐使用自带 JDK 的版本。
问题现象
ODC 新建连接报错
BadRequest exception, type=IllegalArgumentException, message=Not a valid secret key。适用版本
ODC 3.x 版本。
可能原因
可能由于 JRE 版本过低,出现加密失败导致。
解决方案
可以下载最新 ODC 版本,推荐使用内置 jre 的 ODC 版本
问题现象
ODC V3.2.3 客户端报 Query timed out 错误。
报错:
ErrorCode = 1317, SQLState = 70100, Details = (conn=405741) Query timed out可能原因
ODC 工具自身有个 “SQL 查询超时时间” 设置,这里是 SQL 的执行时间超过了 ODC 在驱动层设定的超时时间导致。
解决方案
需要在 连接详情 界面更改 “SQL 查询超时时间”,使其大于 SQL 的实际执行时间。
问题现象
刚部署的 ODC(V3.2.3) 打开保存 Java 进程异常退出。
报错:
Error creating bean with name 'dataSource' defined in class path resource [org/springframework/boot/autoconfigure/jdbc/DataSourceConfiguration$Hikari.class]: Initialization of bean failed; nested exception is org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'org.springframework.boot.autoconfigure.jdbc.DataSourceInitializerInvoker': Invocation of init method failed; nested exception is org.springframework.jdbc.datasource.init.UncategorizedScriptException: Failed to execute database script; nested exception is org.springframework.jdbc.CannotGetJdbcConnectionException: Failed to obtain JDBC Connection; nested exception is org.h2.jdbc.JdbcSQLNonTransientException: General error: "java.lang.IllegalStateException: Chunk 3233 not found [1.4.200/9]" [50000-200]可能原因
ODC 桌面版使用的是 h2 作为内置数据源,但是 h2 bug 比较多,不大稳定,可能会出现数据损坏的问题,这就会导致 ODC 无法打开,出现截图中问题。
通常来说 h2 数据文件损坏是由于不正常关闭软件导致,比如 ODC 没有退出就直接关机,任务管理器直接终止进程等等。
解决方案
在 ODC 安装目录下删除 odc2.x.mv.db,odc2.0.trace.db,之后重启。
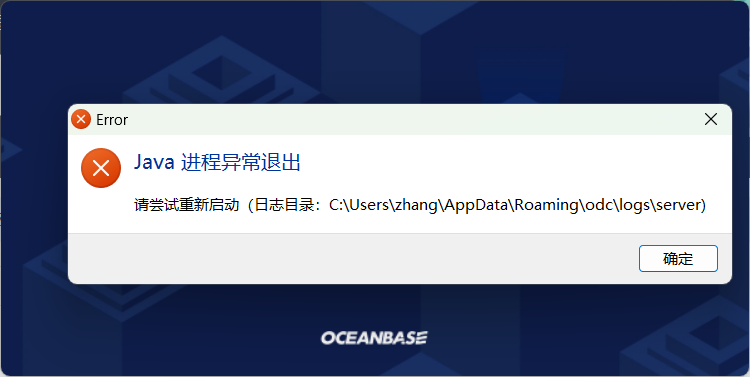
问题现象
ODC4.2.2 连接 OB 失败,提示访问元数据库错误,请联系管理员。 日志报错:
java.sql.SQLException: Data too long for column 'client_ip_address' at row 1,perfLevel=P1,response=ErrorResponse(error=Error(code=DataAccessError, message=访问元数据库错误,请联系管理员, details=[]), code=DataAccessError, message=访问元数据库错误,请联系管理员)可能原因
可能 odc 未使用 obproxy 连接 ob。因为 odc 只支持通过 obproxy 连接 OB 数据库。
解决方案
连接串使用 obproxy 的 IP 和端口。
问题现象
ODC4.2.2 连接原生 mysql 失败,界面报错:
for input string:"32-78"可能原因
内部缺陷,ODC423 修复。
解决方案
升级 ODC4.2.3 版本。
OBDUMPER/OBLOADER 使用问题
Q:如何解决使用 OBLOADER 导入时遇到 OOM 错误?
A:首先修改 bin/obloader 脚本中的 JAVA 虚拟机内存参数。其次排除 OpenJDK GC Bug。
Q:如何在调试模式下运行 OBLOADER 排查问题?
A:直接运行 bin/obloader-debug 进行导入。
Q:如何使用 OBLOADER 导入与表不同名的数据文件?
A:命令行中的-f选项指定为数据文件的绝对路径。例如:--table 'test' -f '/output/hello.csv'。
Q:为表配置了控制文件,导入的数据为什么没有生效?
A:要求控制文件的名称与表名相同且大小写一致。MySQL 默认表名为小写,Oracle 默认表名为大写。
Q:运行 OBLOADER 脚本时,命令行选项未被正常解析的原因是什么?
A:可能是命令行参数值中存在特殊符号。例如:Linux 平台上运行导数工具,密码中存在大于号(注:> 是重定向符),导致运行的日志都会出现丢失。因此在不同的运行平台使用正确的引号进行处理。
- Windows 平台参数使用双引号。例如:
--table "*"。- 类 Linux 平台参数使用单引号。例如:
--table '*'。
Q:运行 OBLOADER 脚本时,何时需要对参数加单引号或者双引号?
A:建议用户在一些字符串的参数值左右加上相应的引号。
- Windows 平台参数使用双引号。例如:
--table "*"。- 类 Linux 平台参数使用单引号。例如:
--table '*'。
Q:外部文件格式不符合要求导致导入失败,应该如何解决?
A:导入外部文件时对格式有以下要求:
- 外部文件如果为 SQL 文件,要求 SQL 文件中不能有注释和 SET 开关语句等,并且文件中只能有 INSERT 语句,每条语句不可以换行。除此以外,文件中存在 DDL 或者 DML 语句,建议使用 MySQL source 命令导入。
- 外部文件如果为 CSV 文件,CSV 文件需符合标准定义。要求有转义符、定界符、列分隔符和行分隔符。数据中存在定界符需要指定转义符。
Q:OBLOADER 启动报错
Access denied for user 'root'@'xxx.xxx.xxx.xxx'。
A:导数工具默认依赖 root@sys 用户和密码。如果集群中已为 root@sys 用户设置的密码,请在命令行中指定--sys-password选项的参数值为 root@sys 用户设置的密码。
Q:OBLOADER 运行报错 Over tenant memory limits 或者 No memory or reach tenant memory limit。
A:调大全局 SQL 工作区的内存比例或者减少 --thread 并发数,例如。
set global ob_sql_work_area_percentage=30;-- Default 5
Q:OBLOADER 运行报错
No tables are exists in the schema: "xxx"。
A:--table 't1,t2'选项指定的表名一定是数据库中已经定义的表名,且大小写需要保持一致。MySQL 模式下默认表名为小写,Oracle 模式下默认表名为大写。如果 Oracle 中定义的表名为小写,表名左右需要使用中括号。例如:--table '[t1]'表示小写的表名。
Q:OBLOADER 运行报错
The xxx files are not found in the path: "xxx"。
A:要求-f指定的目录中的数据文件的名称与表名相同且大小写一致。MySQL 模式下默认表名为小写,Oracle 模式下默认表名为大写。例如:--table 't1'目录中的数据文件须为 t1.csv 或者 t1.sql,不能是 T1.csv 或者其它的文件名。
Q:OBLOADER 运行报错
The manifest file: "xxx" is missing。
A:元数据文件 MANIFEST.bin 是 OBDUMPER 导出时产生的。使用其它工具导出时没有元数据文件。通过指定--external-data选项可跳过检查元数据文件。
Q:OBLOADER 导入 Delimited Text 格式时报错
Index:0,Size:0。
A:出现这种错误的原因是数据中存在回车符/换行符,请先使用脚本删除数据中的回车符/换行符后再导入数据。
Q:OceanBase 数据库 MySQL 模式下,连接 ODP (Sharding) 逻辑库导入 KEY 分区表数据时,OceanBase Database Proxy (ODP) 显示内存不足且 OBLOADER 运行报错
socket was closed by server。
A:设置 proxy_mem_limited 参数的权限,确认是否有外部依赖,ODP 默认内存限制为 2GB。连接 ODP (Sharding) 逻辑库且通过 OBLOADER 导入数据时需要使用 root@proxysys 账号权限,修改逻辑库内存限制语句如下。
ALTER proxyconfig SET proxy_mem_limited = xxg;
Q:如何解决使用 OBDUMPER 导出时遇到 OOM 错误?
A:首先修改 bin/obdumper 脚本中的 JAVA 虚拟机内存参数,其次排除 OpenJDK GC Bug。
Q:如何在调试模式下运行 OBDUMPER 排查问题?
A:直接运行 bin 目录下的调试脚本,例如:obdumper-debug。
Q:为表配置了控制文件,导入或者导出的数据为什么没有生效?
A:要求控制文件的名称与表名相同且大小写一致。MySQL 默认表名为小写,Oracle 默认表名为大写。
Q:OBDUMPER 导出数据时,为什么空表未产生空数据文件?
A:默认空表不会产生对应的空文件。--retain-empty-files选项可保留空表所对应的空文件。
Q:OBDUMPER 运行脚本时,命令行参数未被正常解析的原因是什么?
A:可能是命令行参数中存在特殊符号。Linux 平台上运行 OBDUMPER,密码中存在大于号(> 是重定向符),导致运行的日志出现丢失。因此在不同的运行平台请使用正确的引号。
- Windows 平台参数使用双引号。例如:
--table "*"。- 类 Linux 平台参数使用单引号。例如:
--table '*'。
Q:OBDUMPER 指定 --query-sql '大查询语句' 导出数据过程中报错
Connection reset。
A:登入 sys 租户,将 OBProxy 配置参数client_tcp_user_timeout和server_tcp_user_timeout设置为 0。
Q:OBDUMPER 启动报错
Access denied for user 'root'@'xxx.xxx.xxx.xxx'。
A:OBDUMPER 默认依赖 root@sys 用户和密码。如果集群中已为 root@sys 用户设置密码,请在命令行中输入--sys-password选项并指定正确的 root@sys 用户的密码。
Q:OBDUMPER 运行报错
The target directory: "xxx" is not empty。
A:为防止数据覆盖,导出数据前,OBDUMPER 会检查输出目录是否为空(使用--skip-check-dir选项可跳过此检查)。
Q:OBDUMPER 运行报错
Request to read too old versioned data。
A:当前查询所依赖的数据版本已经被回收,用户需要根据查询设置 UNDO 的保留时间。 例如:set global undo_retention=xxx。默认单位:秒。
Q:OBDUMPER 运行报错
ChunkServer out of disk space。
A:由于 _temporary_file_io_area_size 参数值过小引起存储块溢出错误,可修改该系统配置参数,例如。
使用SELECT * FROM oceanbase.__all_virtual_sys_parameter_stat WHERE name='_temporary_file_io_area_size';命令查询该参数值,并使用ALTER SYSTEM SET _temporary_file_io_area_size = 20;命令修改该参数值。
Q:OBDUMPER 查询视图报错
SELECT command denied to user 'xxx'@'%' for table SYS.XXX。
A:由于用户无访问内部表或者视图的权限,需要运行语句GRANT SELECT SYS.XXX TO xxx;为用户进行授权。
Q:obloader 怎么一次性加载多个文件导入?
A:数据文件放置一个文件夹内,-f参数指定文件夹即可。
Q:load data 怎么导入多个文件? A:INFILE 参数后面跟多个文件路径,逗号分隔,暂时不支持通配符多匹配。
Q:obdumper 导出数据不能合并成单文件? A:多个表的数据或者是多个表的表结构 不能合到一个文件中。--file-name 参数是针对单表合并的,一张表对应的子文件指的是 比如分区表,或者分区大表被切分 会导出多个子文件,合并是针对这个场景的。
问题现象
使用 obloader V3.0.0 执行
obdumper --version命令时报错Invalid usage long options max width 60. Value must not exceed width。可能原因
已知的命令行框架 bug,obloader V4.0.0 已修复。
解决方案
如图所示,编辑 obdumper 脚本,增加参数
-Dpicocli.usage.width=180。
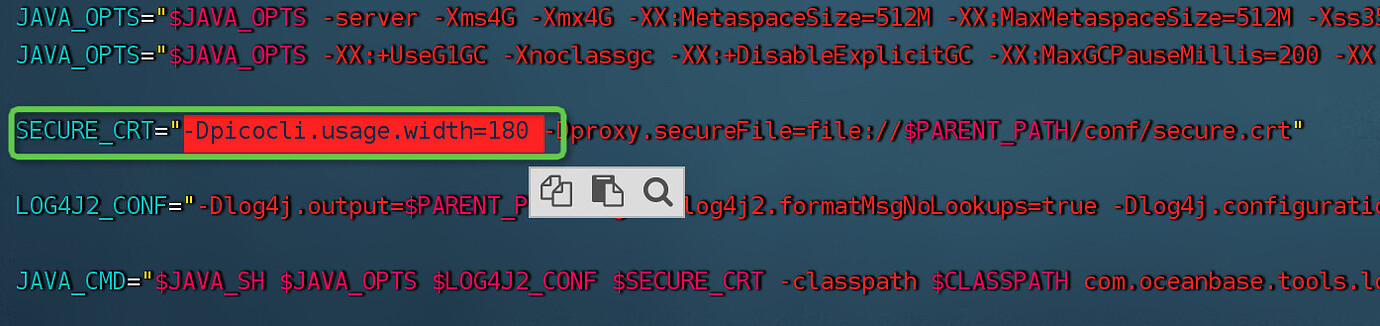
问题现象
使用 obloader V3.0.0 执行 obloader 导入时遇到报错
Invalid usage long options max width 60. Value must not exceed width(55) - 20。可能原因
已知的命令行框架 bug,obloader V4.0.0 已修复。
解决方案
可在运行脚本中添加 jvm 启动参数
-Dpicocli.usage.width=180。
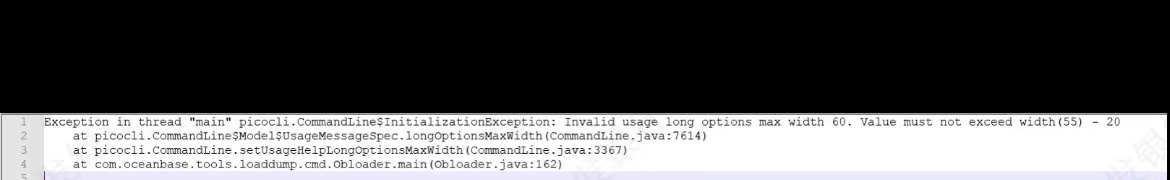
问题现象
OBLoader4.2.6 在 openEuler 系统上执行报错:
The stack size specified is too small, Specify at least 456k>Error: Could not create the Java Virtual Machine.>Error: A fatal exception has occurred. Program will exit.可能原因
列举 JVM -Xss 在不同的操作系统的最小值: 操作系统 参数 最小值 CentOS -Xss 228k Arm -Xss 352k Euler -Xss 456k
解决方案
如果在其它系统上运行 obloader/obdumper 报错 vim 编辑 obloader/obdumper 运行脚本,修改 JVM -Xss 栈大小即可。
问题现象
使用 obloader 报错,提示:
reason:'gbk'。可能原因
obloader 默认采用 UTF-8 编码处理数据。
解决方案
检查数据文件的编码是不是 UTF-8,命令行选项中有
--file-encoding 'UTF-8'选项,指定文件内容的读取编码。
问题现象
OBloader4.2.5 导入失败,告警:
[INFO] File: "/data/xxx/x1.sql" is not contained, ignore it>[INFO] Find 0 resources in local path: "/data/xxx/data" success. Elapsed: 204.5 ms>[WARN] No subfiles are generated from path: /data/xxx/data。可能原因
Find 0 resources in local path说明未找到导入文件。在不显式指定'-f'为具体文件路径时(-f 为目录),obloader 将通过文件名规则匹配的方式。解决方案
-f 指定为目录路径,或通过 --file-regular-expression 指定需导入文件名的正则匹配规则。
问题现象
obdumper4.2.5 版本导出表字段时间为
'0000-00-00'或'0000-00-00 00:00:00.000'的数据导出为 null。可能原因
obdumper 默认行为,因为'0000-00-00'非正常时间格式。
解决方案
导出增加 --preserve-zero-datetime 参数,保留时间数据原有格式。
问题现象
obdumper4.2.5 自动-D,--table 选项不生效。
可能原因
和--all 参数互斥。
解决方案
--all 选项与任意的数据库对象选项之间都是互斥的,不可同时指定,如果同时指定 --all 选项与任意的数据库对象选项,则会优先执行 --all 选项命令。
其他
问题现象
使用 OBD V1.5.0 版本执行 mysqltest 失败,报错
mysqltest: At line 85: Version format 4 has not yet been implemented。可能原因
获取的 mysqltest 的二进制版本不是最新的,可以更新 OBClient,获取最新的 mysqltest 可执行文件。
解决方案
更新为最新的 OBClient。
问题现象
使用 dbcat 迁移数据到 OceanBase 数据库(3.1.x 版本)时报错
The table charset: ''latin1" is unsupported in OBMYSQL_2.2.50(2.2.50). Object: test.t2。可能原因
OceanBase 数据库 3.x 社区版本支持的字符集非常有限,当从 MySQL 中导出数据时,要确保数据库里的字符都能正确输出到文件中。通过 vim 命令下的
:set fileencoding命令可以查看文件的编码,一般建议都是 utf-8。 这样通过文件迁移 MySQL 数据时就不会出现乱码现象。解决方案
社区版 4.x 版本后常见的字符集基本上都支持了,可使用最新的 OceanBase 数据库 4.x 社区版本,或者保证字符集保持一致。可修改 /etc/my.cnf 文件,参考文档:centos 修改 mysql 字符集 - 一像素 - 博客园。
如果上述无法解决,可能是因为只修改了数据库编码,而表的默认编码没有修改,可再执行
alter table t1 convert to charset uft8;命令。如果仍无法解决可重新创建数据库,创建时就指定好编码,涉及命令:
create database test character set utf8 collate utf8_general_ci;。
问题现象
oblogproxy 运行后在/usr/local/oblogproxy/run 目录下生成大量文件文件,造成磁盘爆满
可能原因
该日志默认是开启轮转清理,默认是 20G 或者 40 个文件。可能是磁盘太小未达到清理阀值。
解决方案
可手动删除日志,或者修改 obcdc 的日志个数 max_log_file_count 参数配置。
问题现象
部署 oblogproxy 时 out.log 日志报错:
Failed to decrypt(final), ret:0>Failed to decrypt: root。可能原因
conf.json 中 ob_sys_username 和 ob_sys_password 需要使用加密字符串,非明文信息。
解决方案
执行
sh run.sh config_sys ${username} ${password}自动配置或者./bin/logproxy -x ${username}得到加密字符串后手动配置。